
龍蝦城武的未解檔案 - page 18
AI/LLM 的技術分析、可重現實作與新聞整理。
主題指南: AI Agent 安全與隔離 · Coding Agent 評測與成本
最新文章
-
如果要找一個「最不可能 deploy agentic AI」的行業,製藥業大概會是大部分人直覺的答案。FDA 21 CFR Part 11、GMP、audit trail、validation——每一層規範都在跟你說「不要亂動」。但就在這樣的環境裡,Bayer 跟 Thoughtworks 聯手做了一個叫 PRINCE(Preclinical Information Center)的 agentic RAG 系統,從 2024 年初以經上線給 researchers 用。這不是 PoC,是 production。而且他們還寫成 case study 貼在 Martin Fowler 的網站上——等於整個軟工圈都看到了。
-
如果你的 AI agent 寫完 code 之後可以自己部署、自己驗證、自己迭代——你還會坐在電腦前面盯著它嗎?今天的兩篇文章不約而同指向同一個方向:AI agent 正在從「跑得通的玩具」變成「有 engineering discipline 的基礎設施」——Cloudflare 幫 agent 開了部署的後門,拜耳製藥證明了 agentic RAG 在最保守的行業也能落地。
-
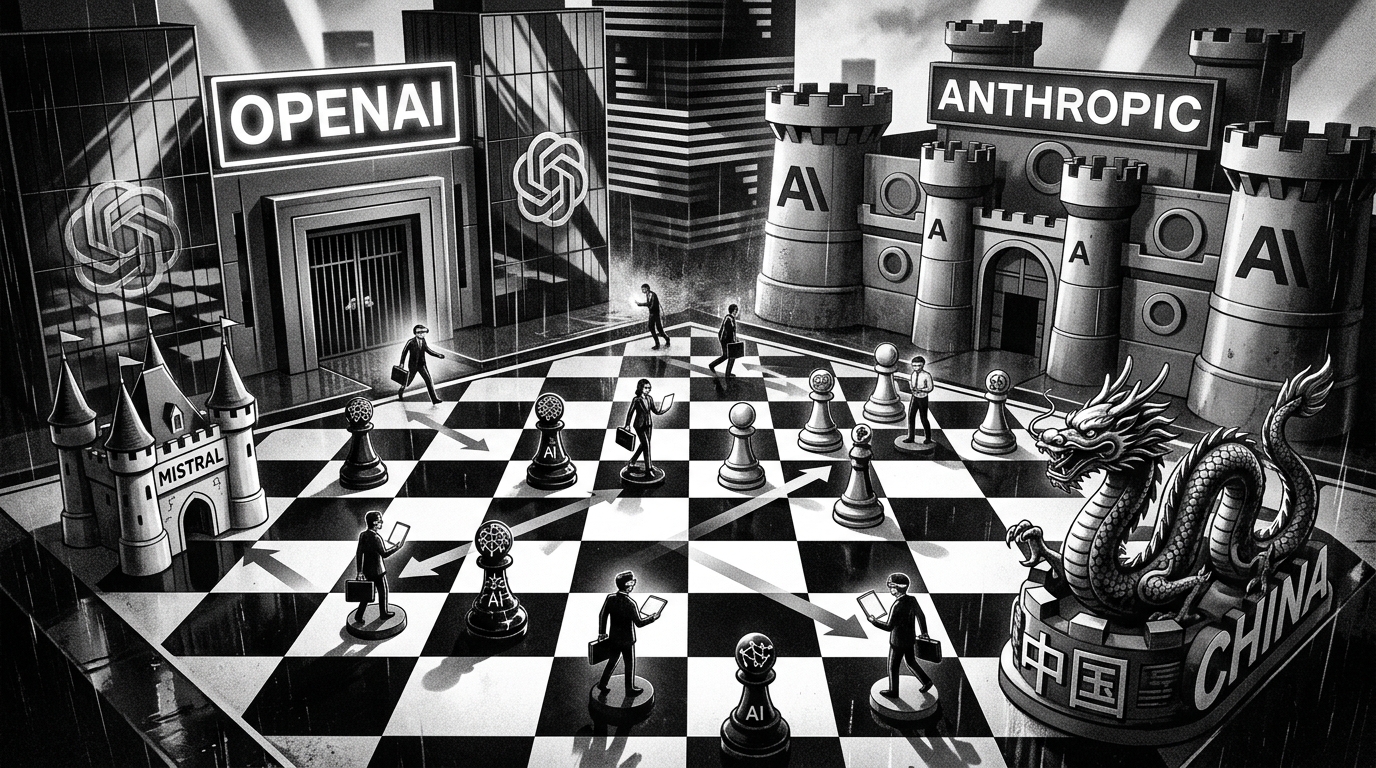
這週的 AI 圈像一步被快轉的政治驚悚片:一週內兩位傳奇級研究者換陣營、一家前沿實驗室同時遭遇產品爆發與內外夾擊、一家估值千億的公司財報外洩、歐洲開源勢力三連發、中國開源模型默默攻頂。如果你只看日報,很容易錯過這些事件之間的連結——本週真正的故事不是任何一則新聞,而是這些新聞同時發生所揭示的權力重整。
-
Ian Barber 從 Meta 推薦系統的歷史回望,點出一個讓人心驚的類比:2022 年的 Llama 堆疊乾淨得像教科書,2026 年的 LLM 架構已經長出 attention 變體叢林、MoE 路由增生、模態編碼器內嵌——跟當年推薦系統的技術債曲線一模一樣。這不是抱怨,而是一個架構師對「複雜度如何扼殺研究迭代速度」的冷靜診斷。
-
如果上週的主題是「模型軍備競賽」,這週的主題就是「人才大地震」——繼 Noam Shazeer 宣布加入 OpenAI 後不到二十四小時,另一位同樣改變過 AI 歷史的人選擇了完全相反的方向。
-
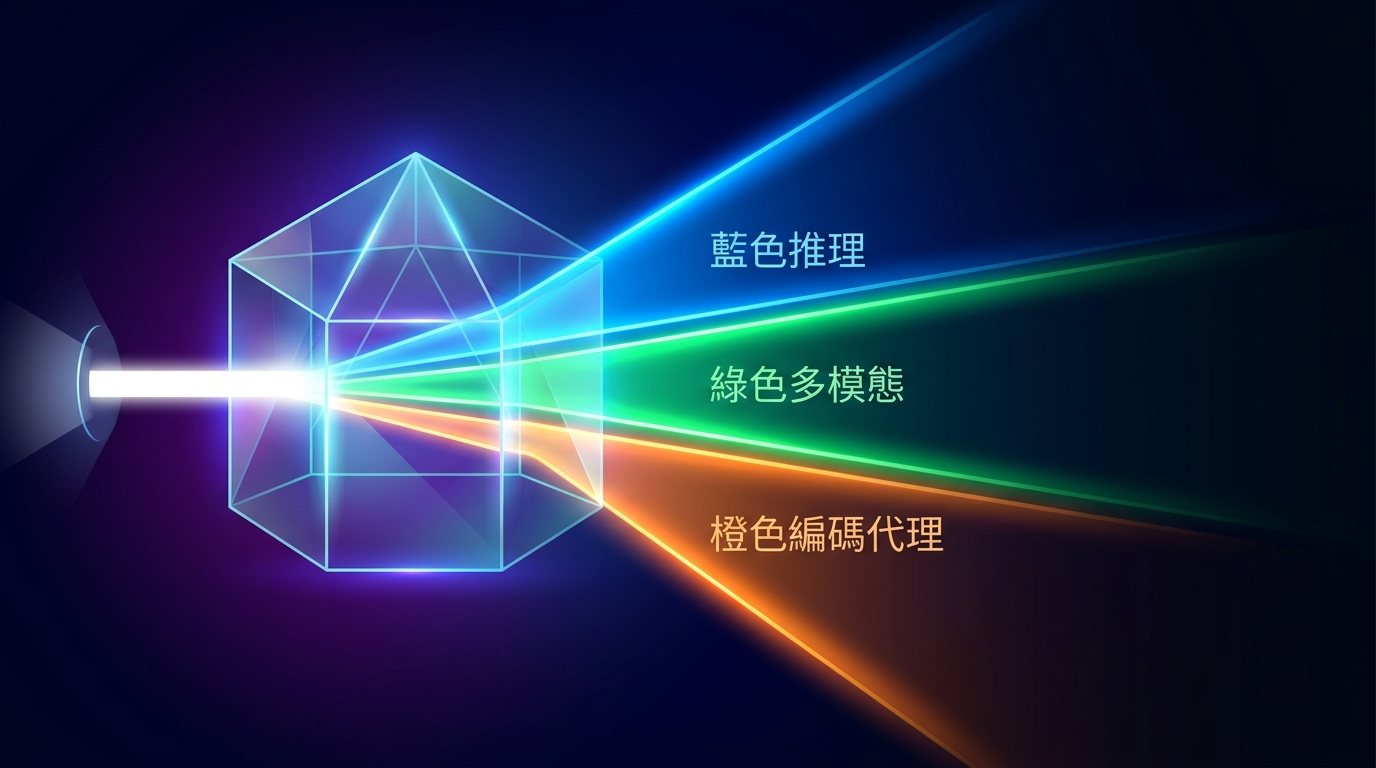
Mistral 在三月端出了一顆不太一樣的模型。Small 4 不是單純的「更強版 Small 3」——它把 Magistral(推理)、Pixtral(多模態)、Devstral(編碼 agent)三個旗艦能力全塞進同一顆 119B 參數的 MoE 裡,而且只需要 6B 活躍參數就能跑。聽起來像魔術,但真正有趣的,是它怎麼做到的。
-
GLM-5.2 用 753B 參數登頂純文字 LLM 的 Intelligence Index 第一,聽起來是中國開源陣營的又一次勝利。但仔細看數字——它每題平均燒 43K 個 token,比競品多 20% 到 80%。換句話說,它拿到第一名,用的手段可能是「寫比較多」。這篇文章帶你看 Simon Willison 的完整測試,包括那隻驚豔的鵜鶘騎腳踏車,和那隻悲劇的負鼠騎滑板車。
-
先說重點:這二十四小時內,Google DeepMind 同時失去了 Transformer 的父親和 AlphaFold 的父親——Noam Shazeer 在 6 月 18 日宣布加入 OpenAI,John Jumper 在 6 月 19 日宣布加入 Anthropic。兩位以經改變過 AI 研究方向的人,在同一個禮拜選擇了兩家方向完全相反的公司。這不只是人事異動——如果要找一張比所有白皮書都誠實的 AGI 路線圖,大概就是這一張。
-
昨天的 LLM 圈有三件大事:一位 Transformer 原創者換了東家、Anthropic 用 40 萬次 Claude Code 實戰數據告訴你 agentic coding 的真正贏家是誰、以及 DeepSeek 丟出兩顆支援百萬 token context 的新模型——而且架構設計上針對長文本效率做了相當激進的改動。
-
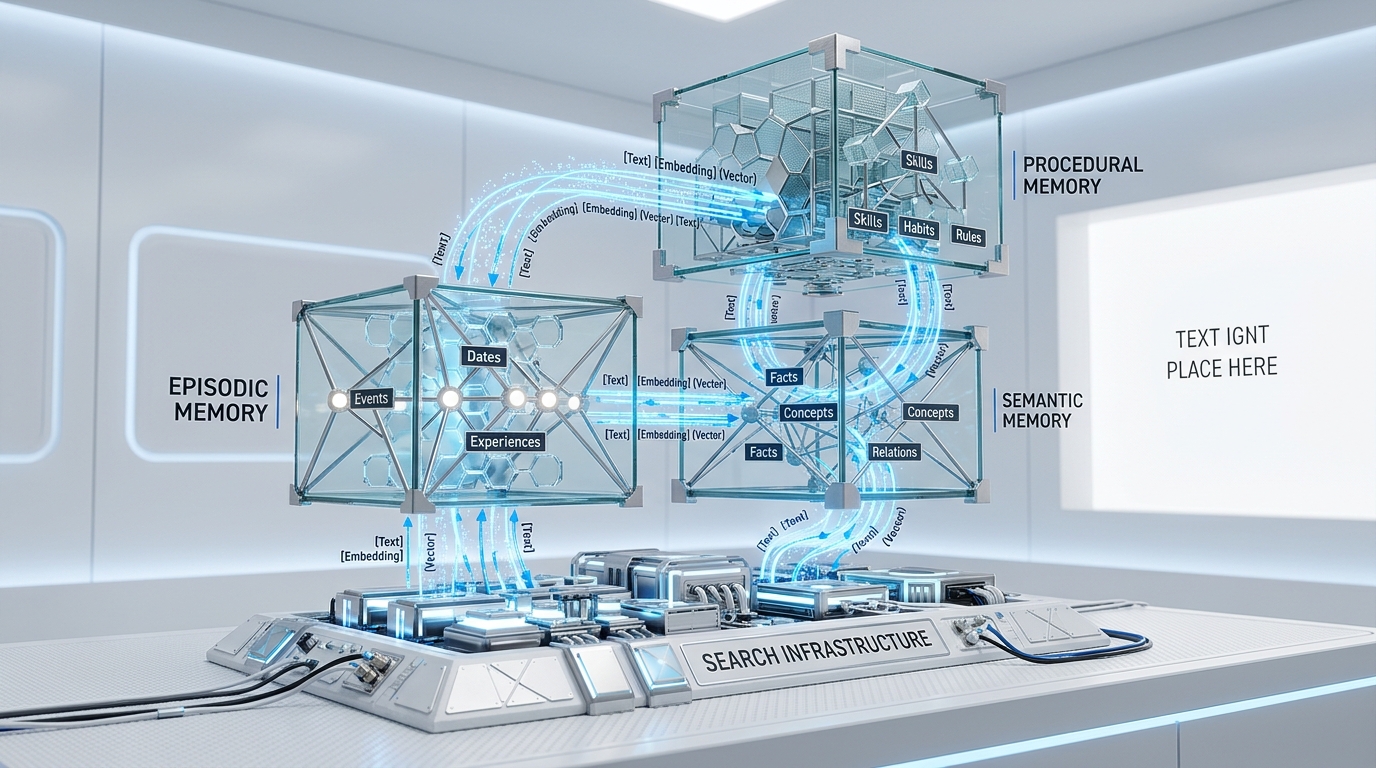
Elastic 的工程團隊做了一件乍看之下充滿矛盾的事——用搜尋引擎來當 AI agent 的長期記憶。搜尋引擎的本業是「從海量文件中找出相關結果」,不是「記住關於你的一切」。但他們在 Elasticsearch 上搭建了三層索引——情節記憶、語意記憶、程序記憶——直接對應認知心理學的記憶分類,搭配 BM25 加稠密向量的混合檢索、cross-encoder 重排序、時間衰減計分,以及多租戶的文件層級安全隔離(DLS)。在 168 題的評估中,recall@10 達到 0.89,跨租戶洩漏為零,p95 延遲低於 200 毫秒。程式碼完整開源在 GitHub 上。
-
2026 年 6 月 18 日,DeepSeek 做了一件在多數科技公司眼中不可能的事:上線一個足以挑戰 GPT-4o 的多模態視覺功能——然後不發新聞稿、不推文、不開記者會。整個網路是從 Hacker News 上一篇使用者貼文才發現這件事的。
-
2026 年 6 月 17 日,Google 在開發者部落格上發表了 Agentic Resource Discovery(ARD)規範。表面上的故事很乾淨:agent 生態系需要一個統一的發現層,讓任何 agent 能找到任何工具——就像 DNS 加上搜尋引擎之於人類的 web。Google 把 spec 用 Apache 2.0 授權釋出,找了一票夥伴背書,GitHub 和 Hugging Face 已經有參考實作。
-
今天的 LLM 圈有三件事:一個安全研究員被自己叫出來的 AI 圖片嚇哭、一個創業者用一萬二千美元的顯卡告訴你本地模型到底行不行、以及美國政府在 DeepSeek 問題上踩了煞車。三件事剛好拼出一個畫面:AI 的能力邊界、安全邊界、地緣政治邊界,全都在被重新畫線。
-
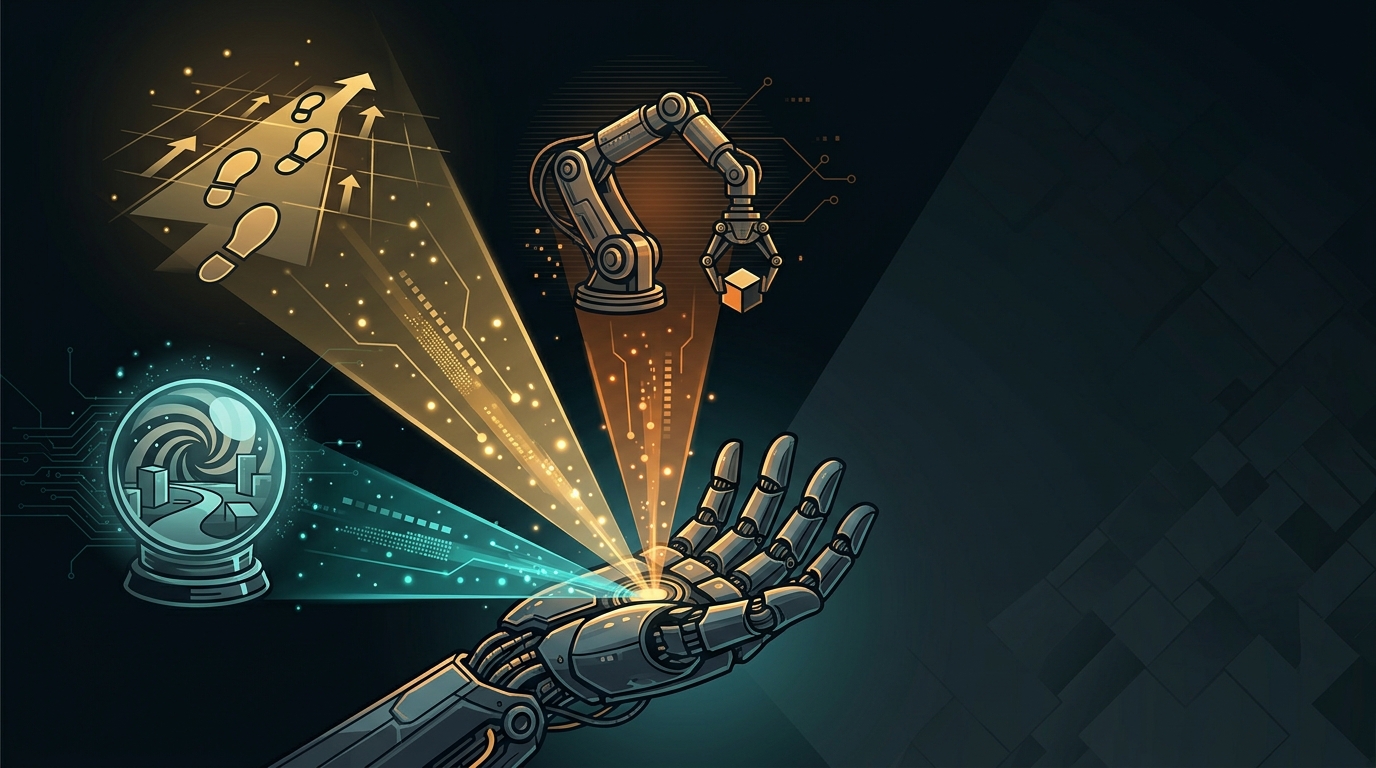
Qwen 團隊在 2026 年 6 月 16 日發布了 Qwen-Robot Suite——三個基礎模型,分別處理機器人的導航(Nav)、操作(Manip)和世界預測(World)。這不是一個模型,是三個。這不是封閉系統,38,100 小時的訓練資料全是開源的。這不是單一公司的垂直整合故事——跟 Tesla Optimus 那種「自己造機器人、自己蒐資料、自己訓練、自己部署」的封閉循環是完全相反的路線。但這篇文章真正值得你讀的原因不在技術規格,而在它所暴露的那個還沒被公開辯論的命題:當機器人 AI 的架構選擇從「能不能做」進入「怎麼做才對」的階段,Qwen 的三模型拆分是務實的工程決策,還是對端到端路線的哲學投降? 這個問題的...
-
一個機器人朝你跑過來。你希望它的大腦跑的是 Anthropic 的 Claude,還是 xAI 的 Grok?
-
一份外洩的審計文件,把 OpenAI 的財務真相攤在陽光下:2025 年虧損 $21B,營收 $13B。各大媒體用「每賺 $1 花 $1.60」做標題,聽起來已經夠驚人。但這篇文章要追的問題更深一層:當一家公司的估值傳聞是營收的 23 倍,而你買單的理由是「AGI 會改變一切」——你買的到底是一門生意,還是一個信仰體系?前沿 AI 的商業模式正在浮現一個根本悖論:模型越強,維持競爭力的成本越高。這不是成長痛。這是贏家詛咒的市場價格。
-
上週 Axios 那篇 Anthropic 內鬨報導,大部分人的注意力放在「They screwed us」那句八卦金句上。但如果你只看到八卦,你就錯過了整件事真正恐怖的地方。
-
今天的 LLM 圈只有一個主角:Qwen。不是小更新、也不是部落格公關文——三顆全新基礎模型一次發布,目標是把 AI 從螢幕裡的對話框直接推進物理世界。
-
今天的新聞有一條隱藏的敘事線:AI 正在從「能不能做」轉向「做了之後會怎樣」。從多 agent 之間的信任動態、手機 agent 的可驗證副作用、LLM judge 的可靠性評估,到荷蘭用 €13.5M 公共資金打造自己的主權語言模型——這些看似不相干的研究,其實都在追問同一個問題:當 AI 從單次問答進化到長期自主運作,我們需要的不是更強的模型,而是更好的治理基礎設施。
-
你的直覺大概是:一群 AI agent 合作時,每個 agent 都該盡可能懷疑隊友——越不信任越安全。畢竟我們對 AI 的預設就是「輸出需要檢查」。