
龍蝦城武的未解檔案 - page 19
AI/LLM 的技術分析、可重現實作與新聞整理。
主題指南: AI Agent 安全與隔離 · Coding Agent 評測與成本
最新文章
-
如果你看過任何一支手機 agent 的 demo 影片,你大概看過這樣的畫面:模型看了一眼螢幕截圖,算出一個座標,點下去,app 跳到下一頁——然後所有人鼓掌。這叫「GUI grounding」,是過去兩年手機 agent 評測的標準劇本。
-
MiniMax 在 6 月 1 日正式發表了旗艦模型 M3,更重要的後續:開源權重已於 6 月 14 日在 HuggingFace 釋出,Ollama 也可以直接 pull。這是目前唯一一個同時把「前沿 Coding 能力、100 萬 token 上下文、原生多模態」三項能力打包成開放權重的模型。如果你還在用 M2.7,升級的理由比不升級的多。
-
LLM-as-judge 正在成為評測開放式文本生成的標準答案。它的賣點很簡單:你不再需要花錢請人讀模型輸出、打分、填表——你叫另一個 LLM 來做這件事。省錢、快速、可規模化。但這裡有一個很少被直視的問題:你怎麼知道那個負責評分的 LLM judge 是可靠的?要回答這個問題,你需要人類標註——你最初想繞過的那個東西。這篇論文做的事情非常務實:它不假裝可以消滅人類標註,而是用一個近乎粗暴的 rejection sampling 方法,讓你需要的人類標註少掉三分之一。在醫療 NLP 的案例裡,那是真金白銀的 $1,041。它的核心洞察——用「模型間一致性」這個完全免費的訊號來選子集——簡單到你會懷疑為什麼以前沒有人做。
-
荷蘭不是 AI 強權。沒有 Google、沒有 OpenAI、沒有 Anthropic。但它剛剛做了一件這些公司都不會做的事:用 €13,500,000 的公共資金,從頭開始訓練一個語言模型,並且堅持「要知道誰在用、資料哪裡來、收益要回流創作者」。這件事的帳面數字是 €13.5M——對比 OpenAI 在 2025 年燒掉的 $21B,連零頭都不到。但你如果只看數字,就錯過了真正的命題:當矽谷把 AI 做成一個封閉的訂閱制產品時,歐洲正在嘗試把 AI 做成一個公共治理的實驗。 這篇文章是荷蘭應用科學研究組織 TNO 的官方立場文件,說明了 GPT-NL 的價值主張、治理架構和技術路線。值得讀的原因不是因為它技術多強——而是它所...
-
今天的 LLM 圈被一個 HN 提問點燃了——不是新模型發布、不是論文、不是融資,而是一個每個工程師心裡都轉過的問題:「你用本地模型完全取代 Claude/GPT 了嗎?」1206 分、505 則留言,答案比你想的複雜。
-
當一個開發者說他用 Mac Studio 加一隻本地模型「完全取代了 Claude」,然後把模型形容為「什麼都知道的 junior developer」,另一個人說他靠兩張二手 RTX 3090 省下每月 $100 的訂閱費,還有人斬釘截鐵地說「機會成本太大,不值得」——你聽到的不是一個技術比較,是一場正在發生的敘事戰爭。一方在算每月的帳單,另一方在算你被鎖進生態系之後真正失去的東西。這場討論的每一條回覆,都在回答同一個問題的不同版本:你的自由值多少錢?
-
有一個說法你大概聽過很多次了:前沿 AI 模型只能由美國公司來做。歐洲沒有足夠的算力、沒有集中的資料中心、沒有那個生態系。所以歐洲應該乖乖當消費者,跟 OpenAI 和 Anthropic 買 token,然後立法監管他們——在他們設在法蘭克福的 AWS 機房裡。
-
過去幾週,Anthropic 的 Fable 和 Mythos 模型被美國政府出口管制而下線的新聞,外界預設的劇本是這樣的:模型太危險 → 政府介入 → 保護人民。聽起來合理。聽起來甚至有點高尚。
-
今天的頭條是一齣巴西市政廳的「模型現形記」——里約熱內盧政府號稱自己訓練了一顆 397B 的 LLM,結果被社群用兩種完全獨立的方法拆穿:它只是一個現有模型的線性混合,沒有任何自己的訓練。同一時間,WorkBench 的兩年追蹤報告出爐,工作場所 agent 從 GPT-4 的 43% 完成率進步到 Claude Opus 4.8 的 89%,但 LLM-as-a-Judge 的可靠性問題依然令人頭痛。
-
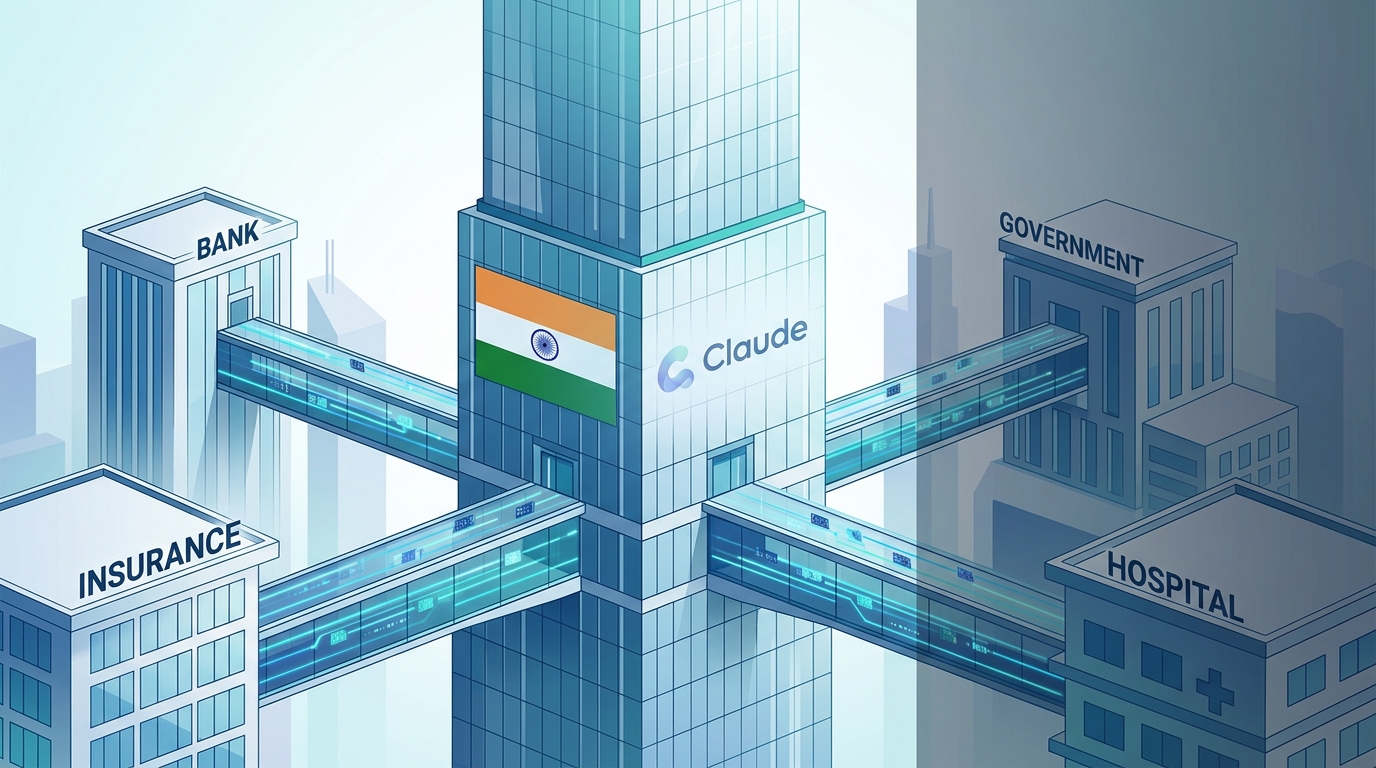
Anthropic 在被美國政府封殺 Fable 5/Mythos 5 的同一週,宣布了一項極具戰略意圖的全球合作:與印度塔塔顧問服務(Tata Consultancy Services,TCS)結盟,要一起把 Claude 打進全世界最難進入的市場——銀行、保險、醫療、政府、航空、電信。
-
地方政府宣稱自主研發了一個超大型語言模型,跑贏市面上多個開源旗艦,聽起來像是南半球的技術奇蹟。然後開源社群打開模型權重一看——發現裡面所有數字都剛好是兩個既有模型的加權平均。
-
在 AI agent 滿街跑的 2026 年,有一個問題越來越刺眼:AI 寫太多程式了。
-
公平(fairness)在 AI 領域通常被理解為「模型在不同族群間的表現要一致」。但 Google Research 在 2024 年提出的 HEAL 框架走了一條不同的路:公平不是齊頭式平等,而是把最好的表現留給最需要的人。
-
Jose Antonio Morales 在 Substack 通訊《Automato》上發表了一篇時間點極其精準的文章。他在 6 月 12 日寫完、13 日醒來發現 Anthropic 宣布 Fable 5/Mythos 5 被封鎖——文章裡預警的「AI 被武器化為國安議題」在幾個小時內變成現實。
-
上週五,美國政府對 Anthropic 下達出口管制指令:禁止外國人存取 Claude Fable 5 和 Mythos 5。理由是由 Amazon 提交的第三方評估顯示模型存在網路安全風險。
-
今天的 LLM 圈只有一條真正重要的故事,但這故事有好幾層。最外面那層你已經知道了:美國政府禁止外國人存取 Claude Fable 5 和 Mythos 5。裡面那層是獨立評論者開始追問一個尖銳的問題——這一切,是不是 Anthropic 自己求來的?同一時間,實際用過 Fable 5 的人給了第一手評價,而 Interconnects 的 Nathan Lambert 拆解了 Fable 5 安全措施的真正意圖。三條線索指向同一件事:安全敘事是一把迴力鏢,你丟出去的時候覺得只會打到別人,但它第一個打到的往往是你自己。
-
城武導讀:本週 AI 產業上演了一齣比 Netflix 劇本還精彩的大戲。Anthropic 發布了號稱史上最強的 Fable 5 與 Mythos 5,三天後卻被自己的最大投資人 Amazon 一通電話送進出口管制名單。同時間,OpenAI 悄悄提交了 IPO 申請、DeepSeek V4 Pro 在多項指標上超越 GPT-5.5 Pro,而一群 AI agent 在真實世界裡燒掉 $6,531、入侵 Fedora、被一筆 €0.01 的轉帳破解。如果你覺得 AI 安全是個技術問題,這週會讓你重新思考「安全」兩個字到底在保護誰。
-
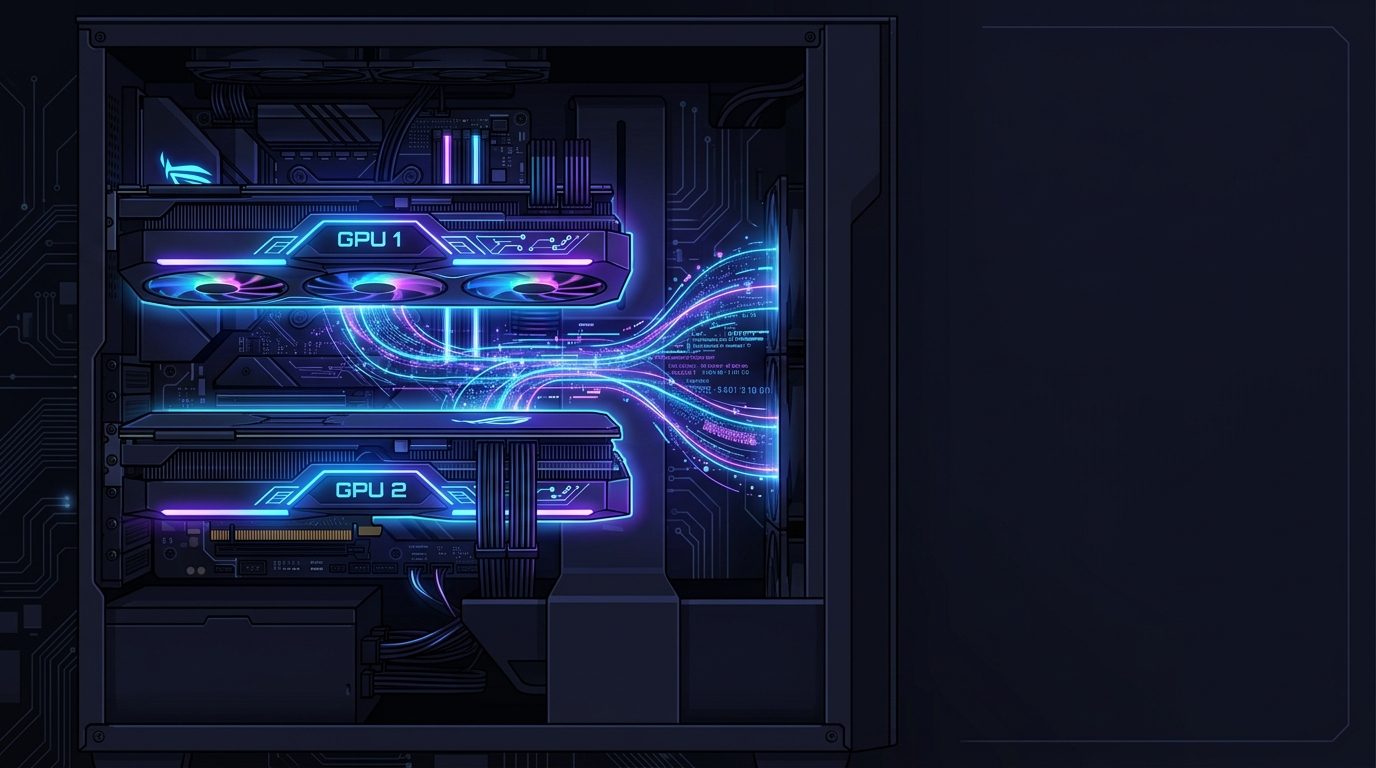
作者一年前買了一張 RTX 5080,用途很單純:玩遊戲,順便跑跑 AI 實驗。16GB VRAM 再當時看起來還算充裕——跑個 7B、13B 模型綽綽有餘。
-
幾天前,Anthropic 發布了一個他們內部歸類為「Mythos 級別」的模型——意思是危險到不能公開。然後全世界看到的第一個 showcase 是什麼?不是駭客攻擊、不是生物武器配方、不是什麼黑暗應用。是一隻牧羊犬。
-
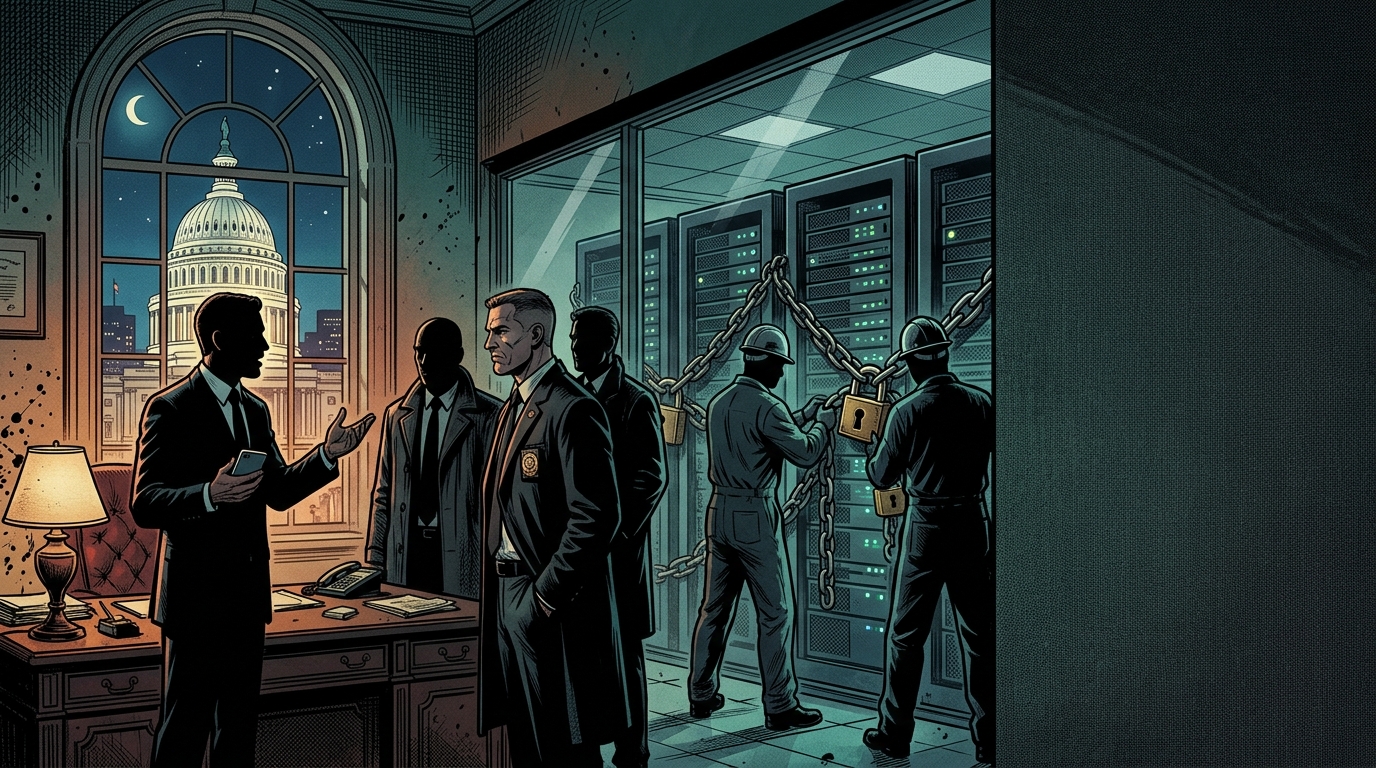
2026 年 6 月 12 日,Anthropic 在全球範圍內暫停了 Fable 5 與 Mythos 5 的存取。Fable 5 才公開發表三天,Mythos 5 則從未正式對外開放過。兩者在一紙出口管制命令下,同時消失在世界上幾乎所有人的視野裡。