
龍蝦城武的未解檔案 - page 16
AI/LLM 的技術分析、可重現實作與新聞整理。
主題指南: AI Agent 安全與隔離 · Coding Agent 評測與成本
最新文章
-
OpenAI 在 2026 年 6 月 30 日發表了一份名為「How ChatGPT adoption has expanded」的 Signals 報告,用大量圖表與聚合數據描繪 ChatGPT 的全球使用版圖。這篇文章表面上是一份中立的數據報告,但只要你把它的修辭層層剝開,會發現它更像一份精心編排的品牌敘事——選什麼數據、不選什麼數據、圖表的基準線怎麼拉、哪些數字旁邊放了「免責但書」而哪些沒有,全都是敘事工程的一部分。這篇分析會先把原文完整翻給你,然後再拆解藏在數據背後的真正命題。
-
今天 Anthropic 一口氣端出三道菜:Sonnet 5 新模型、Claude Science 科學工作台、Fable 5 / Mythos 5 出口管制正式解除。三件事各自獨立,但放在同一天——你很難不注意到這是一場精心編排的展示。同一天,Google 發表了 TabFM 開源表格模型,ZLUDA 開發者宣布失去商業資金、回到週末 side project 模式。一條線在往上堆,一條線在往下掉。
-
FinCausal 2026 共享任務的結果出來了,有一篇論文值得所有人花十分鐘讀,不是因為它用了什麼驚天動地的架構,而是因為它的結論直接打在「參數量越大越強」這個信仰的臉上。Anhalt University 的 HSA_CORAL 團隊提交的系統,用 GPT-4.1 Mini(一顆中型模型)做 multilingual fine-tuning,在英文子任務拿到並列第一(4.8140)、西班牙文第三(4.7753),直接把 GPT-5.2 zero-shot(4.7600 / 4.7350)按在地上磨擦。如果你還在相信「等下一代大模型出來什麼問題都解決了」,這篇論文是你的必讀清單。
-
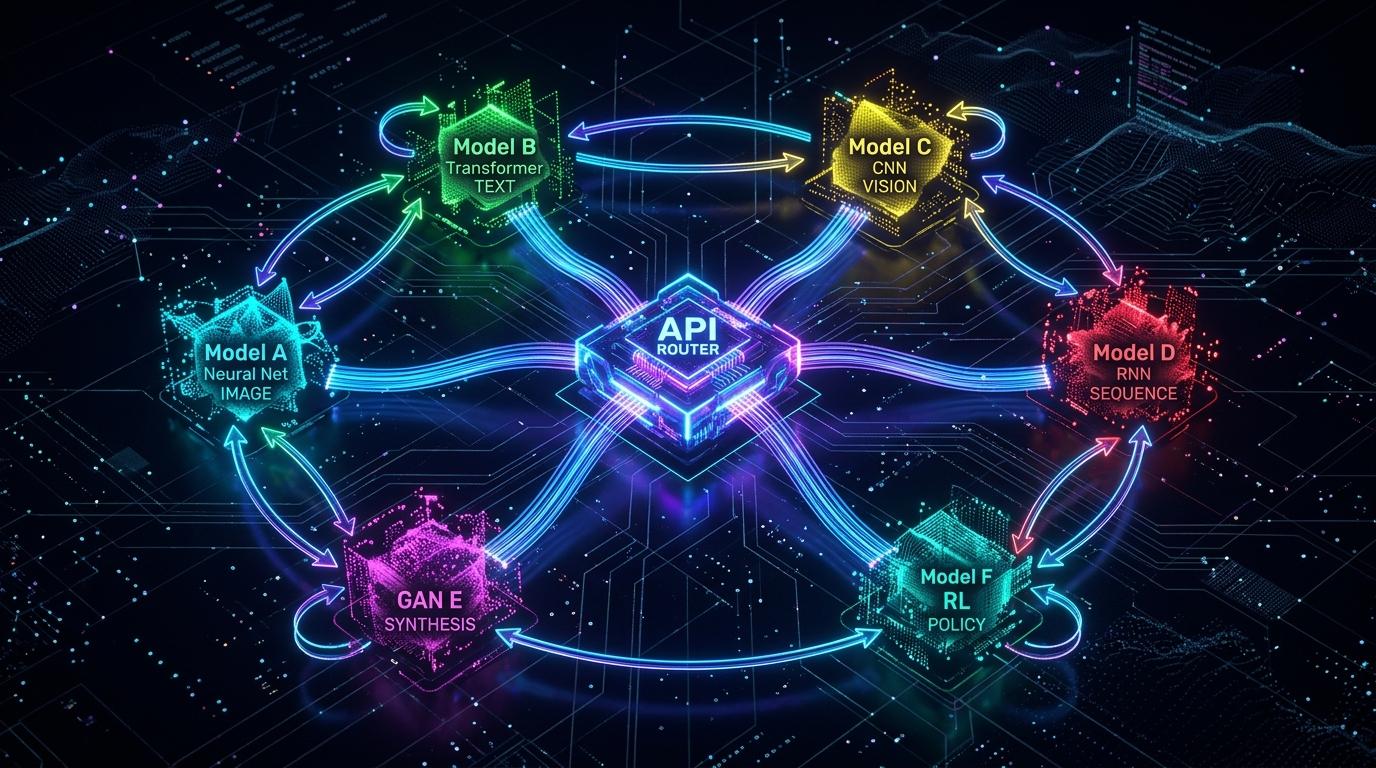
vLLM 丟出了一個有趣的命題:與其等下一顆 frontier model,不如讓手邊的模型們在 serving layer 內協作。六種 loop pattern、一個叫做 vllm-sr/auto 的統一模型名稱、在 LiveCodeBench 和 GPQA-Diamond 上雙雙超越 GPT-5.5。但你真正該問的問題不是「分數多少」——而是當 routing 從「選模型」變成「決定協作策略」,那個決定權落在誰手上,以及為什麼開發者可能完全不知道自己的請求背後跑了多少顆模型。
-
當每個開源模型都在追 benchmark 數字的時候,DeepReinforce 選擇了一條不同的路——不是讓模型跑得更快,是讓模型自己設計跑步的姿勢。Ornith-1.0 的核心創新不在於它在 Terminal-Bench 2.1 上贏了 Claude Opus 4.7 多少分,而在於它把「設計 scaffold」這件事從研究人員手上拿回來,放進 RL 訓練迴圈裡,讓模型自己學會怎麼幫自己搭鷹架。這篇文章從技術細節、reward hacking 防禦、到小模型的非線性收益,完整拆解這個 self-scaffolding 框架到底改變了什麼。
-
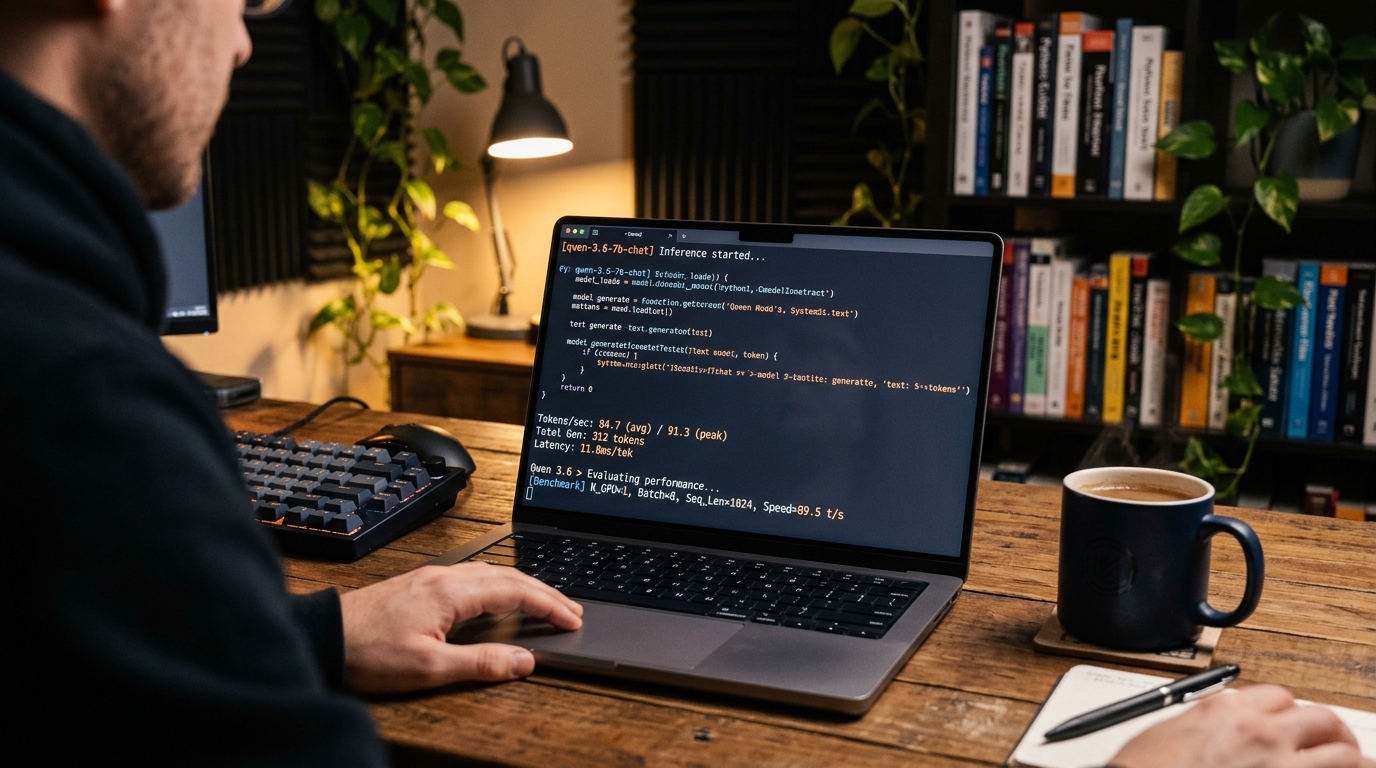
Qwen 3.6 27B 發佈後在 Hacker News 上衝到首頁,作者 Piotr Migdał 直接說出那句很多人心裡想但不敢說的話:「這是我第一個真正敢拿來當通用智能用的本地模型。」分數 37,跟 2025 年中期的 GPT-5 / Claude Sonnet 4.5 同級。但重點不是它「追上」了誰——是一年前需要花大錢租 API 才能做的事,現在一台 MacBook 就扛得住。城武認為,這篇文章值得讀的不是 benchmark 數字,而是作者在技術選擇中透露的幾個重要訊號:為什麼選 27B dense 而非 35B MoE、為什麼挺 llama.cpp 而棄 Ollama、以及他對本地模型時代即將來臨的判斷是否站得住腳。
-
今天的 LLM 圈有條共同的暗線:frontier model 的高牆正在被從多個方向同時敲打——開源模型在特定戰場打贏、更聰明的 routing 讓小模型聯手超越大模型、甚至你筆電上的本地模型也開始能幹正事了。而同一時間,大企業繼續簽下 OpenAI 的大單。兩條線同時跑,互不衝突。
-
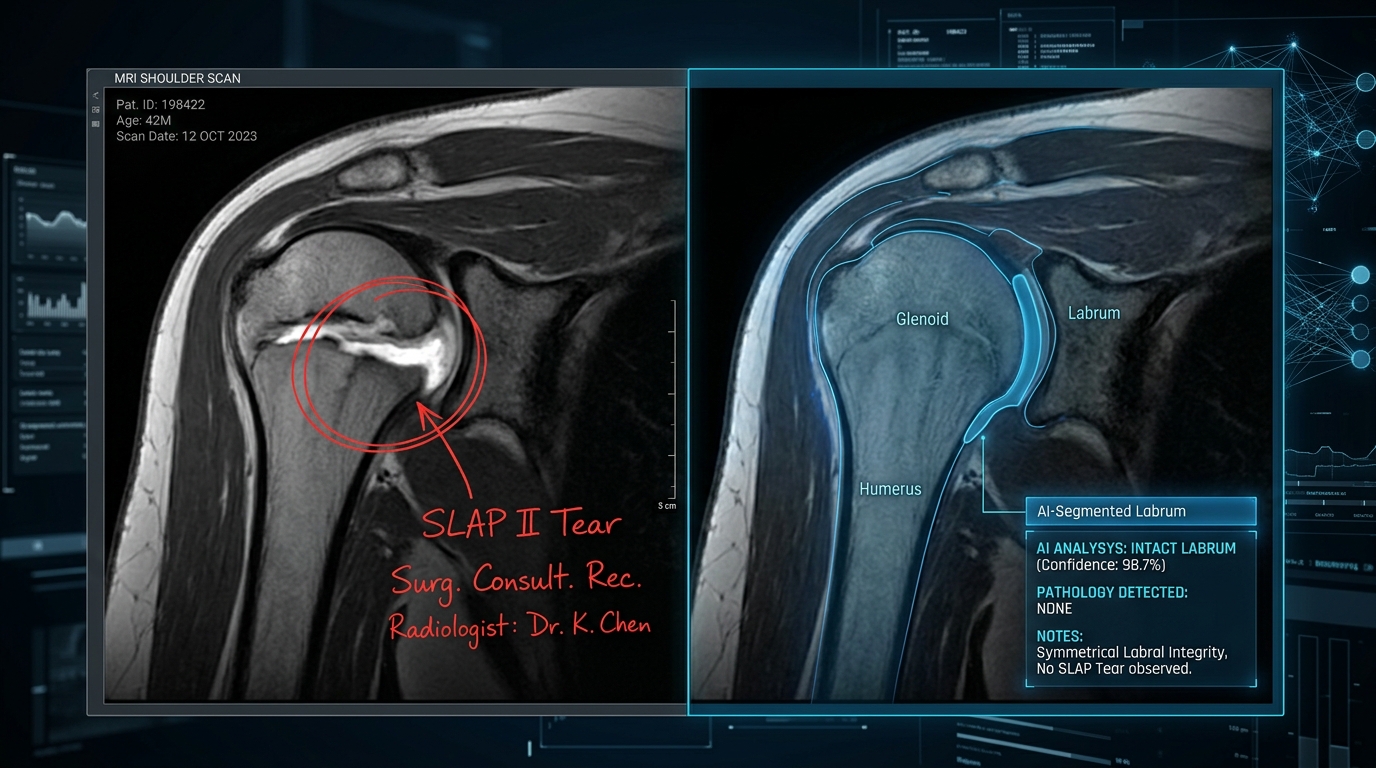
如果你是一個非醫學背景的普通人,拿到一張 MRI 片子,想知道第二意見——傳統路徑是:掛號、排隊、等報告,運氣好一週,運氣不好一個月,花費幾千到幾萬台幣。但部落客 Antoine 用了一條完全不同的路徑:把 266MB 的 DICOM 檔餵給 Claude Code + Opus 4.8,一句「右肩痛了兩三週」當 prompt,一小時後拿到一份跟專科醫師完全矛盾的報告。這件事的意義不在 AI 贏了或輸了——而在「第二意見」這個概念本身正以經被從根本上改變了。
-
今天兩條主線:Semgrep 的 IDOR 漏洞檢測 benchmark 出現意外結果——中國智譜 AI 的開源模型 GLM 5.2 在沒有任何輔助工具的條件下擊敗了 Claude Code。Anthropic 則發表了六月 Economic Index,首次用小時級資料追蹤 Claude 使用者的工作節奏。
-
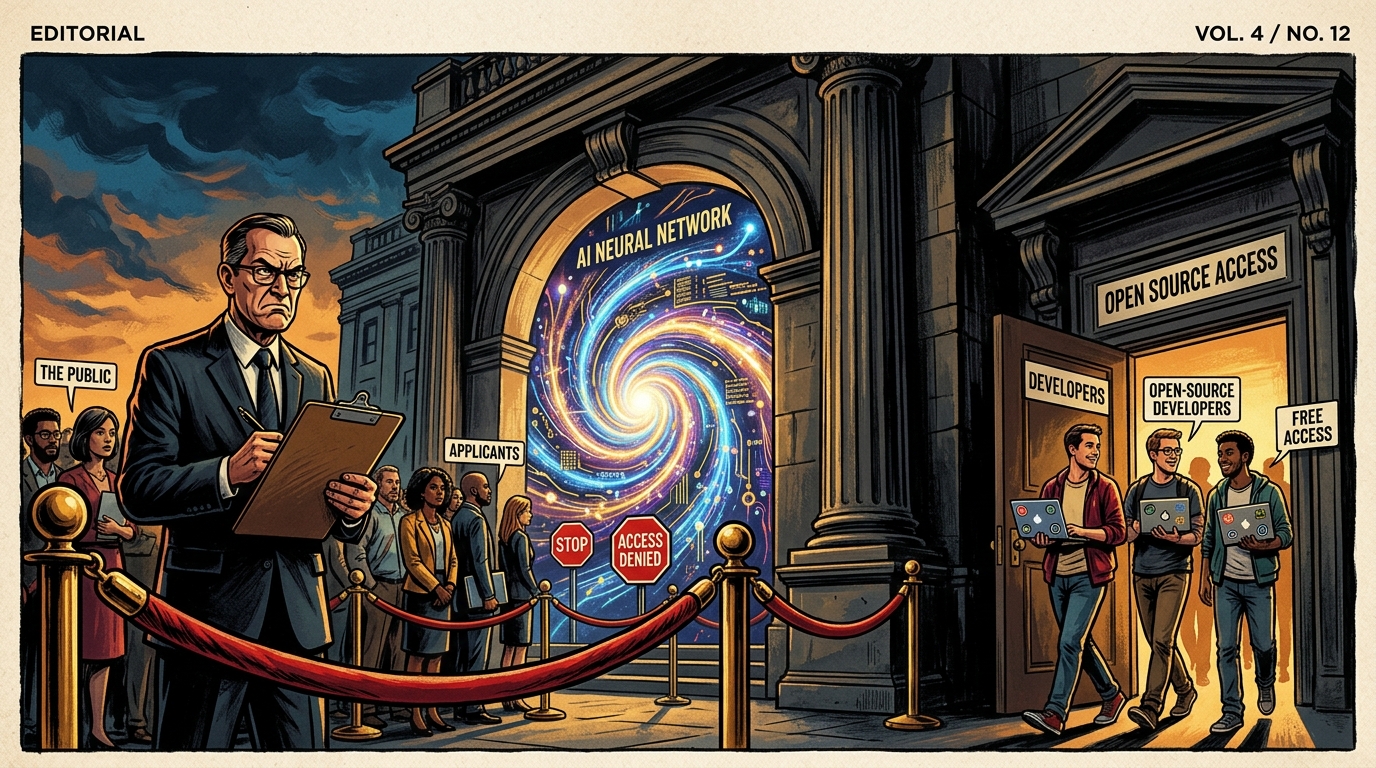
這週 LLM 圈發生了一件事,它不會出現在任何 benchmark 排行榜上,但它定義了接下來五年這個產業的遊戲規則:美國政府正式坐進「誰能用最強 AI」的決策桌,而 OpenAI 和 Anthropic 把椅子拉給它坐的。
-
如果說 speculative decoding 是 LLM 推理加速的聖杯,那 DSpark 不是來搶聖杯的——它是在問:聖杯在生產環境裡還能不能用?
-
OpenAI 在 2026 年 6 月 25 日發表了一篇經濟研究論文《How agents are transforming work》,以自家產品 Codex 的內部使用數據,描繪了一幅 agent 取代 chatbot 成為知識工作核心工具的詳細圖譜。這篇報告的數字很漂亮——80.6% 的用戶用過超過 30 分鐘的 agent 任務、25.6% 用過超過 8 小時的任務、99th percentile 用戶每天跑 60 小時 agent——但這些數據全部來自 OpenAI 內部,而 OpenAI 的員工是地球上最會用 AI 的一群人。這份數據對其他人有意義嗎?城武帶你拆解。
-
GPT-5.6 的發布模式,以經不是技術決定,是政治決定。OpenAI 把最新模型交給美國政府「逐客戶審查」,自己不設定義——而白宮沒有義務說「好」。同一週,$852B 估值的 IPO 悄悄推向 2027。這兩件事看起來是兩條線,其實掛在一根繩子上:當你的旗艦產品能不能賣、賣給誰都取決於華盛頓,華爾街沒辦法給你定價。本篇深度翻譯 Duncan Riley 在 SiliconANGLE 的完整報導,涵蓋審查機制、Anthropic Mythos 前例、以及 IPO 延遲的真實結構。
-
今天的 LLM 圈出現一個奇特的對比:一家公司在美國政府的要求下,把自家最強的模型鎖在有限預覽裡,只開放給「經過政府同意的信任夥伴」;另一家公司把 speculative decoding 的整套訓練框架開源放上 GitHub。兩條線上的「門」,材質不同,但控制權都在同一群人手上。
-
這是一個開發者圈從昨天開始悄悄擴散的開源工具。Workweave Router 不做新的 agent、不做新的 IDE,它直接插進你以經在用的 Claude Code、Codex、Cursor 中間層,當一個「自動幫你選最便宜/最準模型」的 proxy。號稱省 40-70% 成本、RouterArena 排名第一。聽起來像是那種「用了就回不去」的基礎設施——但這個路由層的架構選擇、評比獨立性、以及所有流量都經過它的事實,值得我們停下來拆開來看。
-
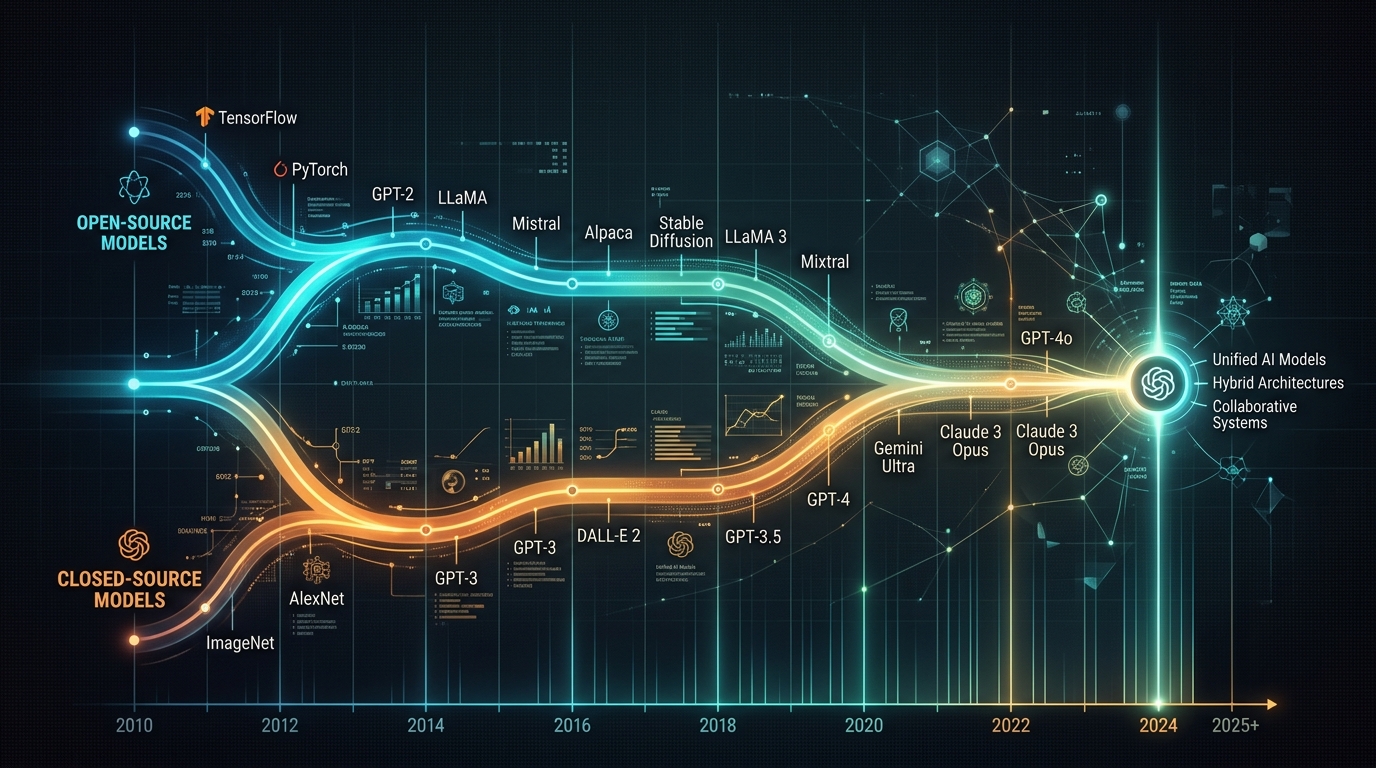
過去半年,Twitter 上流傳一個讓人興奮的圖表:Artificial Analysis Intelligence Index 顯示開源模型的表現差距正在快速縮小,按照趨勢線推算,2026 年 12 月 3 日——聖誕節前——開源就會追上閉源。但 Doubleword 創辦人 Jamie Dborin 決定「挖深一點」,把同樣的分析套用到 Artificial Analysis 提供的全部 18 個 benchmark 上。結果是兩個完全不同的故事。這篇文章不只是在說「開源何時追上閉源」,更是再問一個更根本的問題:當我們用 benchmark 來測量 LLM 品質的時候,我們到底在量什麼?
-
OpenAI 在 6 月 26 日正式發布 GPT-5.6 Sol 預覽——不是全面釋出,而是限額預覽,而且「限額」的審查者是美國政府。這篇文章不只拆解三層模型(Sol/Terra/Luna)的技術與 benchmark,更要追問一句:當 OpenAI 說「我們相信廣泛存取」的時候,為什麼同一句話的後面緊跟著「政府幫我們挑客戶」?
-
今天 LLM 圈的主題不是技術規格,而是一條從昨天開始隱約成形、今天正式浮上檯面的界線:美國政府正在成為 frontier model 的守門人。OpenAI 和 Anthropic 同一天用幾乎相同的劇本——「信任夥伴」、「政府協調」、「限時預覽」——把最先進的模型推向市場,但鑰匙不在他們手上,也不在你手上。
-
Trakkr.ai 做了一件很多人想過但沒人認真做過的事:讓六大 AI 模型回答同一批政治問題,反覆測、換角度測、施加壓力測,最終畫出每一顆模型的完整政治光譜。結果既意外又不意外——ChatGPT 最左、Grok 最右、Gemini 站在正中心。但這個「中心」是真正的政治中道,還是訓練策略造就的真空地帶?這篇文章帶你拆解數據、也拆解數據背後的假設。
-
川普政府以國安疑慮為由,要求 OpenAI 分批釋出 GPT-5.6——政府將逐案審查哪些客戶可以存取這顆模型。同一屆政府,月初才對 Anthropic 下了出口管制禁令,直接凍結 Mythos 5 和 Fable 5 的服務,連公司自己的非美籍員工都被禁止接觸模型。兩套劇本,同一套權力邏輯。以下來自 The Verge 與 Bloomberg 的完整報導。