
【深度翻譯】一條 GPU 寫入指令,如何在快取與 DRAM 間留下漫長後續
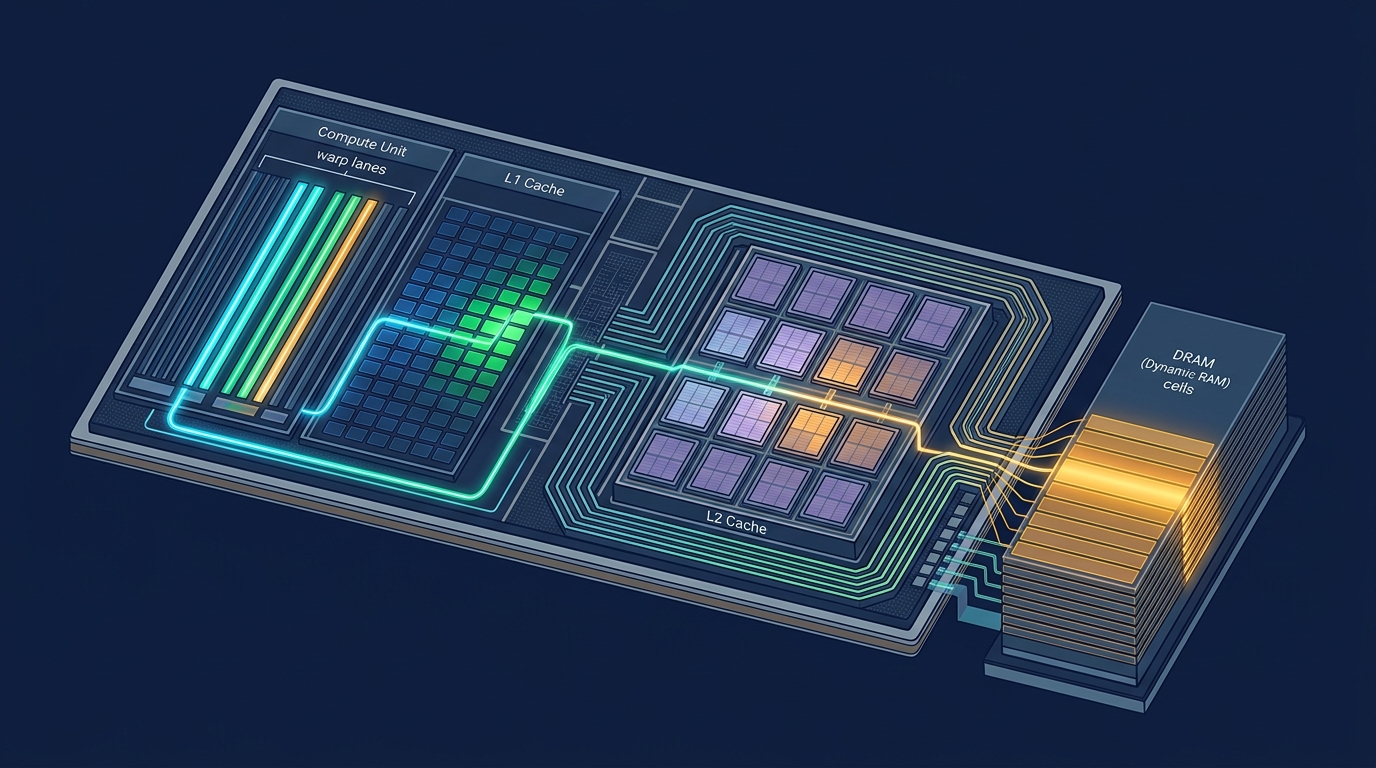
一條 STG.E 看起來只是在 GPU 上把一個結果寫回記憶體;但對發出它的 warp 而言,「指令已完成」、資料已進入 L2、資料能被其他 SM 看見,以及資料真正落到 DRAM,都是不同時刻。Doubleword 的 Fergus Finn 以向量加法為例,追蹤這條寫入指令離開 SM 後的路徑,也把快取替換、髒資料回寫與可見性這幾件常被混成一件事的問題拆開。
原文摘要
開場:向量加法的最後一步
作者延續前一篇追蹤 GPU 讀取的文章。範例 kernel 做的是向量加法:先載入 a[i] 與 b[i],以 FADD 算出結果,最後由 STG.E [R6.64], R9 把 c[i] 寫出去。也就是說,本文關心的不是運算本身,而是這個 store 指令從 warp 發出後,資料究竟去了哪裡。
原文把這段經歷分成兩個尺度:前段是資料從 SM 出發、穿越 L1 與互連、抵達 L2,並收到確認;後段則是資料留在 L2 成為髒資料,直到未來的快取壓力迫使它被回寫到 DRAM。後者可能發生在原本寫入它的 warp、甚至整個 kernel 都結束很久以後。
離開 warp:從 STG.E 到合併器
在這個例子中,R9 放著加法結果,R6 與先前的位址計算共同給出目標位置。STG.E 送進 load/store unit(LSU)後,作者量到同一個 warp 大約每 6 個 cycle 可以再推出一條新的 STG.E。SM 的出口每 cycle 可維持 32 bytes 的讀取或寫入;當許多 warp 同時密集發出記憶體操作時,這個出口便會成為瓶頸。原文註明,這些時序是用 %globaltimer 量得,而不是由公開規格直接讀出。
下一站是 coalescer,也就是把同一 warp 的存取整理為 sector 請求的單元。原文以四個 sector 為例:讀取時,每個 sector 一律拉進完整的 32 bytes,之後 LSU 才按照實際 SASS 指令所要求的部分,把結果送進暫存器。寫入的方式不同:每個 sector 請求帶著 byte mask,指出哪一些 byte 真正要被覆寫。因此,這次操作向 L1 送出四個 sector、四個遮罩與合計 128 bytes 的資料。
這個差異很重要:store 不必把每一個被送往下游的 byte 都當成有效寫入;遮罩保留了「哪一部分要改」的資訊,讓後續快取與記憶體端能處理局部更新。
穿過 L1:保留副本,但立即往下送
四個 sector 到達 L1 cache。作者把這條路徑描述為 write-through:寫入會穿過 L1 往下送往 L2,同時 L1 仍保留一份副本。若這次寫入需要在對應 set 中騰出空間,舊 slot 會依嚴格的 LRU 次序讓位。
原文在註腳中把這個判斷拆成三個問題:store miss 時是否會在 L1 配置一個 line?L1 hit 時,store 後副本是保留還是丟棄?資料是寫入當下就送到 L2,還是等 L1 eviction 才送?作者根據觀測將此處歸為 write-through,而不是 write-around 或 write-back。這是對所研究路徑的實驗性推斷,不是本文聲稱的通用 GPU 設計定律。
在 L1 下方,store 的虛擬位址會被轉譯;接著四個 sector 穿過 crossbar,前往擁有這條 cache line 的 L2 slice。原文引用前文的讀取追蹤,指出這裡涉及地址轉譯與依實體位址決定 L2 歸屬的流程。
抵達 L2:依實體位址找到其中一個 slice
請求穿過 crossbar,送到 36 個 L2 slice 中的一個。作者說,選擇哪個 slice 的函數,與前一篇文章逆向推得的實體位址函數相同。這個請求攜帶 cache line 的位址、最多四個 sector 的資料,以及各 sector 的 byte mask;store 以每條 line 一個請求的方式送出。
在 slice 內,原文描述每個 cache 為 16-way set-associative、具有 1,024 個 set,並以實體位址雜湊。如果查找時該 line 已常駐,對應 sector 的 byte mask 所選中的 bytes 會被寫入 slot,這些 sector 也會標記為 dirty。之後會送回 acknowledgement;四個 sector 便以帶著遮罩的髒資料狀態留在該 slot 中。
原文用 512 MB 的連續寫入掃描搭配 ncu 計數器,支持「每條 line 一個 store 請求」這項觀測。它也提醒讀者,這些是從實驗和計數器反推而來的行為模型。
完成寫入:確認回到 SM,warp 早已往前走
acknowledgement 接著穿過 crossbar 回到發出 store 的 SM。此時,最初發出指令的 warp 早已繼續執行;在作者這個極小的 kernel 裡,甚至整個 kernel 都已經結束。因此,ack 到達 LSU 後只是在那裡被消耗,並不代表 warp 一直停在原地等待。
更值得注意的是,這個例子中的資料其實沒有立刻到 DRAM。作者在先前的範例中,以 cudaMemcpyDeviceToHost 讀回這些寫入結果;此時硬體把資料以 dirty 狀態保存在 L2。就原文所追蹤的 STG.E 而言,寫入已完成,但「完成」指的是它已抵達可確認的位置,不等於已經寫進外部顯示記憶體。
一條 store 指令的後半生
L2 是整顆晶片流量的序列化點,但其容量有限,終究得淘汰資料。寫入資料目前住在 L2;之後另一個 kernel 可能讀、可能寫,可能剛好想要同一批 line,也可能只需要其他 line。隨著新的工作持續進來,原先的髒資料終究得離開 L2,走向 DRAM。
作者接下來討論的重點不再是最初那條指令如何前進,而是 L2 如何決定誰留下、誰被逐出,以及資料被逐出後怎麼回寫。
資料如何前往 DRAM:RRPV 與替換候選者
原文為每條 L2 cache line 引入 2-bit 的 re-reference prediction value(RRPV)。作者用 0、1、2 三個層級示意:數值越低,cache 越相信這條 line 很快會再被使用。作者特別說明,這是示意用法,並不表示硬體內部真的以字面上的 0、1、2 儲存;時序實驗只把它鎖定為三個層級。新插入的資料 line 位於中間層級,也就是示意的 RRPV=1。
對一條常駐 line 的 hit,讀取命中會把它調到示意的 RRPV=0;若是 store hit,對應 sector 寫入 line,而 dirty mask 也隨之更新。若是 miss,則啟動替換流程。
替換時,cache 先掃描 set 的 16 個 way,尋找 RRPV=2、即被預測近期不會再使用的 line。若找不到,就把所有 RRPV 一起提高一級後再掃描。在所有 RRPV=2 的候選者中,選擇最久未使用的一條作為 victim。若新 line 最終獲得位置,便插入該 way,並從示意的 RRPV=1 開始。
作者對這整個狀態機的推導也給出方法上的但書:先以已知 line 填滿一個 set,再插入目標 line,持續對同一個 set 串流會干擾目標的 line,計算原目標變成 miss 前要經過多少次填入。藉此可分別定位替換演算法的各部分;在不只做單點測試時,還能畫出存活曲線來看不同 line 被逐出的分布。
髒 victim 與 write-back buffer
選到 victim 後,必須判斷它是否為 dirty。原文的模型是:髒 victim 先被送進 FIFO 的 write-back buffer,回寫工作開始後,它在該緩衝區的某段時間仍可讀取;而緩衝區每經過兩次 fill,最舊的 line 會被彈出以騰出位置。作者認為,這可解釋為何髒 line 相對於乾淨 line,會在一連串干擾填入下多存活一段額外時間。
具體來說,作者以 D 條髒 line 和一條目標 line 的實驗觀測到:相對於乾淨 line,髒 line 會多撐大約 2D−1 次干擾 fill,D 可從 1 到 8。這符合「髒 line 先進入每 set 的隊列、每兩次 fill 才排出一個」的解釋。作者也以這組實驗支持同一 RRPV 層級內以 LRU 打破平手的判斷。
原文接著描述,若找到的 victim 是 dirty,系統會讓它進入回寫流程,之後繼續在 ways 中尋找乾淨 victim;找到乾淨者後,才把它逐出並把位置交給新 line。這裡的關鍵是,髒資料不是在需要位置的瞬間就憑空消失,而是進入另一段受緩衝與回寫能力限制的生命週期。
讓 set 保持乾淨:八條髒 line 的清潔規則
前述策略說明了為新資料騰位置時如何 eviction,但還有一個問題:如果後續操作一直命中既有的髒 line,單靠 miss 引發的替換策略,並沒有機會把它們回寫出去。
因此,原文描述額外的主動清理規則:當一次 store 進入某個 set,而該 set 的 16 條 line 中有至少 8 條是 dirty,系統會先找出其中最久未被 store 的髒 line,把它的髒 sector 送到 memory controller,並標記為 clean;之後才進入前面描述的策略。作者把它形容為清潔工:不是等到垃圾堆滿入口才處理,而是提前留下乾淨的可替換者。
作者也解釋了沒有這條規則會發生什麼。假設一個 set 的 16 條 line 全是髒的,而新的 miss 需要從 DRAM fill 資料。替換策略會先挑最舊的髒 line,送到 write-back buffer;接著下一條、再下一條,全都髒、全都開始回寫、全都塞入緩衝區。結果是 16 條 line 同時形成一波 DRAM 寫入。緩衝區尚未排空前,這個 set 幾乎沒空間應付接下來幾次 miss;更糟的是,這波寫入還會在 memory controller 排隊,使同一控制器上的其他讀寫也排在後面。
原文以一個互動示例呈現這項規則:kernel 先寫出 16 條 output line,再串流讀取 32 條 input line。沒有主動清理時,髒 line 的累積會使替換與回寫擠在一起;八條髒 line 的門檻則把回寫分散到較早的時刻,讓後續較有機會找到乾淨 victim,也讓通往 DRAM 的流量更平滑。
回寫:非同步直到控制器的寫入積壓滿了
寫入 L2 的請求,和 L2 對 DRAM 的回寫可以非同步進行。作者指出,直到某個 memory controller 的 write backlog 填滿前,新的 store 都可以繼續進來;一旦積壓滿了,新的 store 就必須停住。作者並提醒,依前文的實驗模型,一個 memory controller 由三個 L2 slice 共用,因此某一處的回寫壓力會在共享控制器的隊列上造成影響。
真正執行回寫時,髒 sector 會先去 memory controller,再作為 write 送到 DRAM 晶片。原文註腳補充,RTX 4090 的 GDDR6X 可直接套用 byte mask;帶 ECC 的 HBM 則因以 codeword 運作,不能用完全相同的直接方式處理局部寫入,而會以讀取、合併、再寫回完成 partial write。另一個測試顯示,掃描 512 MB、每個 sector 只寫一個 byte,與寫完整 line 所送出的 DRAM 寫入 bytes 相同;這也提醒人們,軟體看見的有效寫入量,不必等同底層記憶體介面實際承擔的寫入流量。
結論:warp 已離開,資料仍在路上
作者把 store 的旅程總結為一段很長的後半生。warp 發出 store 後,資料先穿過 L1、送進 L2,L2 再向原始 SM 回覆確認。warp 除非需要讀回結果,否則不會知道資料後面還要經過什麼;它可以快樂地繼續往前,而 L2 裡的資料則以 dirty 狀態等待。
隨著新的 load 與 store 進來,這些 line 老化,直到某次 miss 選中它們作為 victim。它們才經由 memory controller 被送往 DRAM,抵達時間可能遠晚於寫入它們的 warp 已經消失之後。原文的視覺化以「先寫 128 MB output、再串流讀 96 MB input」示範這個過程:L2 中每個 set 的髒 line 數量會變化,36 個 slice 及其共享的控制器則承接讀寫積壓與 DRAM 流量。
附錄:可見性不是「寫入已完成」的同義詞
原文把可見性另列一節。STG.E 做了實際的 store,但其他執行者何時能讀到它,是另一個問題。fence 是讓 warp 停住,直到它此前發出的所有 store 在某個 scope 內變得 visible 的指令。文中列出三種 PTX scope:membar.cta、membar.gl、membar.sys;作者也註明,這些 PTX 指令會展開為不只一條 SASS 指令。
對同一 block 可見:在 L1 會合
membar.cta 對應 block(CTA)範圍。原文把它稱為「在 L1 會合」:在同一個 block 內,若其他 thread 要以同步語意看見先前的 STG.E 寫入,就需要這個範圍的 fence 所保證的可見性。原文的 fence 成本測量方式,是在迴圈中發出 N 次 store,並以 %globaltimer 包住測量區間。
對所有 SM 可見:在 L2 會合
membar.gl 對應 device 的全域範圍。原文把它描述為「在 L2 會合」,也提醒「全域可見」並不是一句抽象口號:在實務上,讀取端使用的指令與快取狀態同樣會影響能否看到新資料。原文提到 LDG.E.STRONG.GPU、ld.acquire.gpu 與 CCTL.IVALL,用以指出全域可見性與 L1 狀態之間的關係;原文措辭是「原則上才是 globally visible」,不把它簡化成只要資料在 L2 就萬事大吉。
這些 fence 也是雙向的:它們不只確保先前 store 對外可見,也負責讓該 thread 後續的 load 看得到自己先前寫入的資料。因此,作者從 cuobjdump -sass 看到的 SASS 序列中,membar.gl 與 membar.sys 都含有記憶體屏障、錯誤屏障與 L1 失效相關操作;fence.acq_rel.gpu 與 acquire load 也各有對應的序列。相較之下,原文列出的 membar.cta 序列較短。這些名稱與組合是作者檢視到的反組譯結果,而不是本文試圖替所有 GPU 版本下總結的固定模板。
對整個世界可見:membar.sys
membar.sys 是 system scope。原文把它放在「對整個世界」這個尺度討論:當可見性需跨出 GPU、抵達系統層級時,不能只停在同一個 block 或同一張 GPU 上的其他 SM 所共享的位置。它代表的等待與同步範圍,也因此比只談一條 store 是否已被 LSU 接收更大。
讀回先前 store 時,究竟等了什麼?
本文範例 kernel 的 PTX 沒有自己放 fence:它只是寫入資料後結束。然而,隨後的 cudaMemcpyDeviceToHost 需要的語意,正是 system-scope 的 membar.sys。作者指出,driver 會在 kernel 結尾排入相近的 system-scope membar;當該 membar 解決,資料才對 host 可見,接著才能傳回並印到螢幕上。
原文最後的註腳補上可觀測線索:可以讀到 CWD_MEMBAR_TYPE = L1_SYSMEMBAR,而其等待成本和作者量測的 membar.sys 大致相同。這解釋了為什麼這個範例即使沒有在 kernel PTX 中手寫 fence,host 端的讀回仍取得了所需的可見性,而不是因為最初的 STG.E 一發出就已經自動對所有人可見。
城武觀點
我站在一個很樸素的工程溝通原則:別再把「instruction 完成」說成「資料已經到位」。原文最有用的地方,不是替讀者背出某張 GPU 的內部名詞,而是把完成、快取中的髒資料、不同 scope 的可見性與 DRAM 回寫拆成不同問題。高階 AI 應用很愛講吞吐量、token 與 kernel 跑完了沒有,但並行程式真正出錯時,常常就卡在另一個 thread、另一個 SM 或 host 何時能合理讀到結果。若只用「寫好了」掩蓋同步邊界,成本最後會由除錯的人支付。這篇文章所描述的是作者以特定觀測建立的模型;工程文件若不說清楚適用範圍、讀取端的前提與同步責任,也會把有用的直覺誤包裝成普遍保證。
城武的未解檔案——一條寫入先抵達的,往往不是 DRAM,而是人們對「完成」二字過度樂觀的想像。
- 原文:What happens when a GPU writes memory(Doubleword, 2026-09-09)