
【深度實作】SynthID 文字浮水印怎麼測?CPU 實跑 96 份生成,也把誤報攤開看
文字浮水印不是在句子裡塞一個看不見的字元,而是在選下一個 token 時,留下可以事後打分的統計訊號。問題是:訊號看得見,是否就足以判斷來源?這次真的在 CPU 上跑了 96 份模型生成。正確密鑰下,兩個長度的水印測試樣本都檢出;但 128-token、未加水印的 12 份對照,也有 3 份被判陽性。
所以本文不只展示一張漂亮的檢出圖。我們先用一段純 Python 淘汰賽看清機制,再接 Hugging Face 的正式 SynthID processor,把取樣、有效位置、校準、誤報與文字重新分詞逐項攤開。這裡用的是公開小模型與自選實驗密鑰,不是能驗出真正 Claude 浮水印的工具。
原文摘要
起點是 Sebastian Raschka 在 2026 年 8 月 22 日發布的〈How Claude Watermarks AI-Generated Text〉:一段約 48 分鐘的影片,從 token 取樣一路說到浮水印與偵測。這是八月的技術講解,不是今天的新公告;以下主體是本站另外寫程式、跑模型得到的實作紀錄,而非影片逐字稿翻譯。[1]
Anthropic 的技術頁說,Claude 使用 SynthID-Text 的一個版本,標記不靠隱藏字元;偵測回答的是 Claude 曾參與文字生成的可能性,不是「這一定由人寫」的反面證明。該頁目前列出的偵測 API 仍為符合條件組織申請的 private preview。本實驗沒有其正式密鑰、部署設定或商用偵測器,因此要驗證的是公開機制,不是假裝複製了整套 Claude 服務。[2]
第一層:先看一個 token 怎麼贏淘汰賽
玩具程式的詞彙表只有 256 個 token,各自原始機率相同。每一步先抽 16 個候選,再打四輪兩兩淘汰賽。每輪的 g 函數,根據實驗 key、層數、前面三個 token 與候選 token,產生一個 0 或 1;遇到 1 對 0,就留下 1,平手才隨機選。
這是自製的教學類比,不是 SynthID 全部細節。玩具用 SHA-256 取 bit,正式版本另有 hashing、sampling table 與重複 context 處理,不能用玩具替正式版本的密碼學安全背書。
在專案目錄執行:
from main import toy_trace

trace = toy_trace(seed=42, key=123)
print(trace["original_candidates"])
for row in trace["rounds"]:
    print(row["layer"], row["winners"])
print("final:", trace["final_token"])
實際輸出是:
[57, 12, 140, 125, 114, 71, 52, 44, 216, 16, 15, 47, 111, 119, 13, 101]
0 [12, 140, 114, 44, 16, 15, 111, 13]
1 [12, 44, 15, 13]
2 [44, 13]
3 [13]
final: 13
第一對 57 與 12 的 bit 都是 1,所以這一對不是「12 比 57 更像正確答案」,而是平手後由固定 seed 的亂數選了 12。後面每輪換另一層的 g 判斷,最後 13 勝出。候選仍來自原來的取樣分布;密鑰改變的是淘汰時的偏好,不是另往文字插入標籤。
偵測時也不必重跑語言模型,只需在收到的 token 序列上重建 context,算同一組 g,看平均 bit 是否偏高。這個「生成時讓訊號偏高、事後用同一規則找回訊號」的配對,是 SynthID 論文的核心機制之一。[3]
同一份 256-token 玩具輸出,實跑的 mean-g 為:
- 未加水印、正確 key:
0.504941。 - 加水印、正確 key:
0.754941。 - 同一份加水印序列、改用錯誤 key:
0.500000。
這些是 bit 平均值,不是「75% 機率由 AI 寫」。玩具使用的 0.65 門檻也是明示的教學設定,不是校準過的實務誤報控制。
低熵對照:只有一個答案,淘汰賽沒有空間操作
再把每一步候選固定成 token 7。無論開不開水印,輸出都是同一串 7,因為根本沒有其他 token 可選。
更容易漏掉的是偵測端:256 個輸出位置,不等於 256 份新證據。排除不完整 context,再去掉重複 context,這串固定輸出只剩 1 個有效位置。程式回傳 detected: null,而不是把一個原始分數硬當成有把握的陰性或陽性。這個對照同時測了「有沒有選擇空間」與「有沒有新的有效位置」。
正式 SynthID processor 不會真的抽出海量候選
如果每層都把淘汰樹展開,層數一多就會很昂貴。Transformers v4.57.1 的 update_scores() 採用向量化重加權。對某一層,令 p 是目前 token 機率,g 是該層的 bit,可寫成:[6]
mass = 所有 token 的 p × g 加總
新機率 = p × (1 + g - mass)
用本站自製的兩-token 例子核算:原本 p(a)=0.75、p(b)=0.25;若這把 key 在該 context 給出 g(a)=0、g(b)=1,則 mass=0.25,重加權後 a 為 0.5625、b 為 0.4375。相反的 bit 配置則得到 0.9375 與 0.0625。這些數值是依公式實算的教學例,不是 Claude 的實際詞彙分布。
因此,「不失真」不能解讀成每一把固定 key、每一步的機率都完全沒變。論文把不同強度的 non-distortion 分開定義,其中單 token 性質涉及對隨機種子取平均等條件;固定 key 下會出現可偵測偏好,正是我們要看的訊號。本文沒有品質盲測,也不拿分布性質替實際文筆品質打包票。[3]
第二層:真正接上 CPU 語言模型
實驗不是把幾段人造 token 當成模型輸出。這一層載入 distilbert/distilgpt2,實際呼叫 model.generate();兩組共用模型、提示與對應 seed,只有 watermarked 組傳入 SynthID 設定。
環境固定為 Python 3.11.15、Transformers 4.57.1、torch 2.8.0+cpu,CPU 使用 4 threads、1 interop thread。模型 revision 固定為:
2290a62682d06624634c1f46a6ad5be0f47f38aa
載入時不啟用 remote code,使用 safetensors,也不需要 API key。
生成設定是 temperature=1、top_k=40、top_p=1、do_sample=True。新生成長度分為 64 與 128 tokens;為了固定比較長度,兩者都設定 min_new_tokens=max_new_tokens,不讓這一段提早因 EOS 結束。這是在受控環境中固定長度,不是測自然結束回答的實際長度分布。
正式 processor 使用 5-gram、8 層實驗 keys,sampling table 大小 65,536、table seed 0、context history 1,024。這些公開設定可在 real_lab.py 查到,它們是本實驗選值,不是 Claude 正式設定。Hugging Face 的整合介面讓我們透過 watermarking_config 接入生成,不必重新訓練語言模型。[5]
不能拿未訓練的 Bayesian detector 當答案
正式 SynthIDTextWatermarkDetector 需要已訓練的 Bayesian detector module。這次沒有假裝訓練了那個模型,而是用官方 processor 重建 g-values 與有效位置,再取簡單平均。DeepMind 參考實作也列有不需訓練的 Mean/Weighted Mean 路線,以及需訓練的 Bayesian 路線。[4][7]
本站的打分核心直接對應實作:
import torch

ids = torch.tensor([tokens], dtype=torch.long)
g = processor.compute_g_values(ids)
mask = processor.compute_context_repetition_mask(ids)
mask &= processor.compute_eos_token_mask(
    ids, eos_token_id
)[:, processor.ngram_len - 1:]
score = float(g[mask].float().mean()) if mask.any() else None
這段為什麼不能簡化成把所有 bit 全部平均?因為前面四個 token 還湊不成完整 5-gram;EOS 後的內容不應算入;重複 context 也不該反覆充當新證據。程式先把 prompt 切掉,只對新生成部分打分,生成端也略過最初四次水印呼叫。編輯過序列後,整套 g-values 和 mask 都重新計算。
校準、測試、錯誤 key:三件事不能混用
每個長度各生成三組:
- 24 份 calibration plain:未加水印,只用來定門檻。
- 12 份 evaluation plain:未加水印,用來數誤報。
- 12 份 evaluation watermarked:加水印,用來數檢出。
校準與測試的 topics、prompts、seeds 分開;測試中的 plain 與 watermarked 用相同 prompt/seed 配對,是控制變項,不是兩批彼此無關的文件。這些都是少量手寫英文故事提示,不是代表真實世界分布的隨機抽樣。
總共是 96 次原始生成。每份再做四種條件、兩把檢測 key,因此留下 768 條打分紀錄;不能把它寫成 768 份獨立文章。
門檻採用一個透明但粗糙的方式:
threshold = max(calibration_scores) + 1e-12
positive = score > threshold
它依「原始長度 × 編輯條件 × 檢測 key」分成 16 組,各自只使用對應的 24 份未水印校準資料。錯誤 key 也有自己的 plain 校準/測試組,不是把錯誤 key 當成唯一陰性對照。
這樣必然讓本批 calibration 的超標數是 0/24,但這是設定的結果,不是誤報率保證。新的文件可能超過先前見過的最大值;校準與測試提示組的差異也可能改變分數分布。DeepMind 的參考說明要求在不同長度下另外考慮門檻,本次把這件事落實了,卻沒有因此得到商用校準的證書。[4]
實測:水印全部檢出,未水印卻不是全部放行
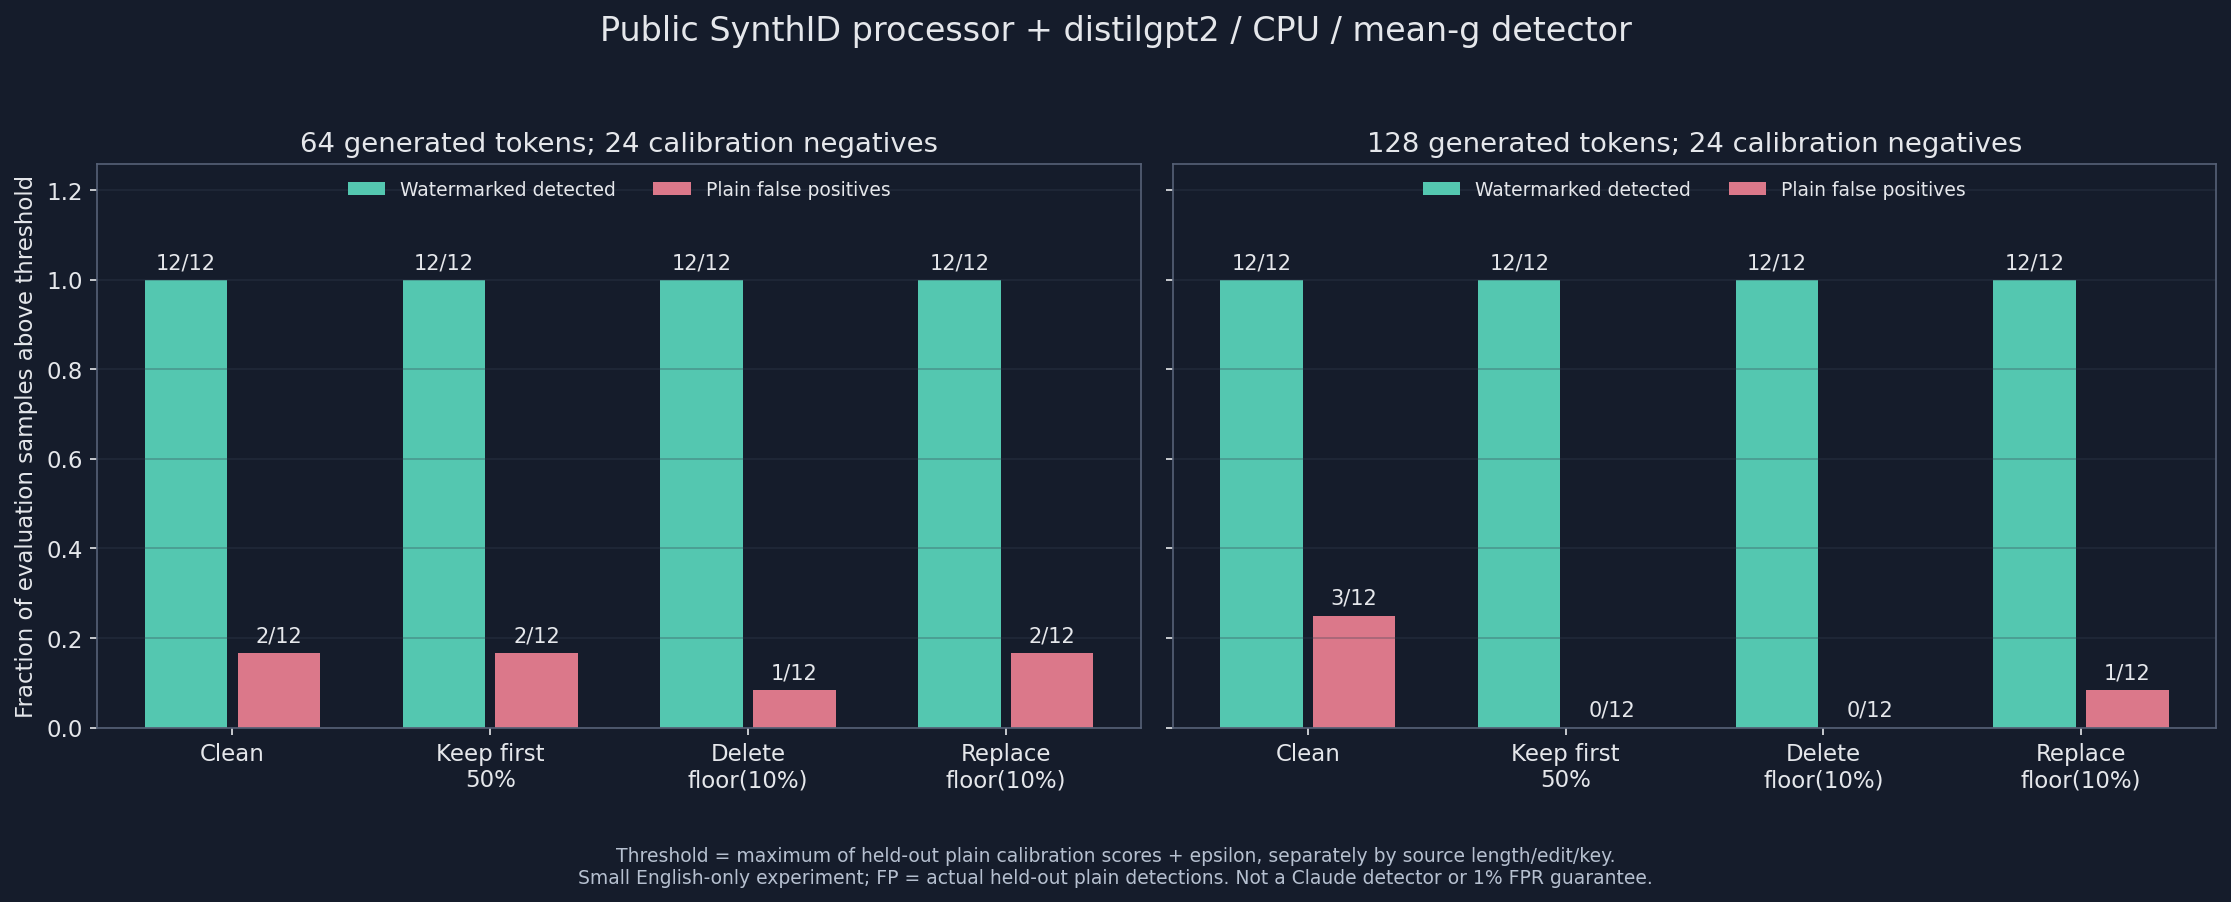
綠柱是水印樣本檢出,紅柱是未水印樣本被誤判;柱上都保留分子/分母。正確 key 的結果如下,每一條都是另外保留的 12 份 evaluation:
原始 64 個新生成 tokens:
- 不編輯:水印檢出
12/12;plain 誤報2/12;門檻約0.531250。 - 留前半:水印檢出
12/12;plain 誤報2/12;門檻約0.540179。 - 刪除約一成 token:水印檢出
12/12;plain 誤報1/12;門檻約0.532407。 - 替換約一成 token:水印檢出
12/12;plain 誤報2/12;門檻約0.533333。
原始 128 個新生成 tokens:
- 不編輯:水印檢出
12/12;plain 誤報3/12;門檻約0.525202。 - 留前半:水印檢出
12/12;plain 誤報0/12;門檻約0.541667。 - 刪除約一成 token:水印檢出
12/12;plain 誤報0/12;門檻約0.544393。 - 替換約一成 token:水印檢出
12/12;plain 誤報1/12;門檻約0.543347。
錯誤 key 對水印樣本的結果也不是永遠零:64-token 的四種條件都是 0/12,128-token 未編輯組為 1/12,其他三組為 0/12。完整 JSON 另外保留錯誤 key 對 plain 的誤報數,而不是只挑有利的對照。
每種編輯條件都另外校準了門檻,這不是拿一個部署門檻盲測所有未知編輯。128 截成 64 的組別,也不是原始 64-token 組別。這批結果能說的是:在本設定與對應校準下,訊號經這些簡單編輯仍可檢出;同時,這個小型 mean-g 流程沒有可靠隔開所有未加水印輸出。不能拿 12/12 換成「偵測百分之百可靠」,也不能把這批誤報外推成 Claude 的誤報率。
編輯會改哪裡?先把 token 與文字分清楚
這次的變形不使用另一個模型重寫句子。截短是保留前半;刪除/替換則固定 seed,操作 floor(length/10) 個位置。因此 64-token 組動 6 個、128-token 組動 12 個,比例都是 9.375%,不是精確 10%。替換可能破壞字詞,沒有測語義是否保留。
5-gram 偵測看的是局部窗口。刪除一個 token,不只少了一個 token 的分數,也改變附近窗口;替換後的 token 和周邊 context 也會組成不同輸入。所以程式重新打分,不能把原來的有效位置遮罩直接搬過去。
還有一個比編輯更早出現的問題:同一串生成 token,轉成文字再重新 tokenize,不保證拿回相同 token IDs。
這次另外記錄 decode → encode 診斷,兩個長度合計、每份只算一次,不重複算兩把 key:
- 未編輯:plain 有
16/72不相同;watermarked 有7/24不相同。 - 留前半:plain
12/72;watermarked3/24。 - 刪除後:plain
28/72;watermarked10/24。 - 替換後:plain
34/72;watermarked13/24。
plain 的分母包含校準與測試;watermarked 只有測試,所以兩者分母不同。JSON 保存重新分詞後的 IDs、分數與有效位置數,但沒有把它們套原 ID 門檻就宣稱完成文字端評估。若下一步要做「貼一段文字就能測」的介面,必須先把解碼、正規化、重分詞與重新校準納入同一條管線;目前主結果嚴格停在 token-ID 層。
自己跑:先看機制,再跑模型,最後核對數據
完整程式、固定依賴、原始生成與逐筆打分放在 synthid-text-lab 專案。不需要 GPU 或付費模型 API;首次真模型實驗需要網路下載公開權重及套件。
git clone https://github.com/chengwulongxia-rgb/deep-dive-code.git
cd deep-dive-code/synthid-text-lab
uv sync --locked --python 3.11

# 純 Python:看 toy 分數與淘汰賽 trace,不下載模型
python3 main.py

# 正式 processor 與 CPU 模型;另放輸出,不覆蓋已發表數據
uv run python main.py --real --threads 4 --output results/rerun
本次 AMD Ryzen 5 5600GT 上,96 次生成本身合計約 225.42 秒;包含模型載入、打分與重新分詞診斷約 248.53 秒,不含環境安裝、繪圖與後續 audit。這不是所有電腦的執行時間保證,模型輸出也沒有接受品質盲測。
只想重畫已保存圖表,不需要再載入模型:
HF_HUB_OFFLINE=1 TRANSFORMERS_OFFLINE=1 uv run python main.py \
  --chart results/redrawn.png --input results/real.json

uv run python -m unittest -v
HF_HUB_OFFLINE=1 TRANSFORMERS_OFFLINE=1 uv run python audit.py --replay
本次 9 項測試通過。audit 重新計算 768 條 g-values/mask/score、16 組門檻,並核對校準/測試切分;另從 plain 與 watermarked 各取一份重生兩次,四次都逐 token 一致。這四次驗證不計入主要 96 份,也不拿來重新挑門檻。
要修改實驗,可從 real_lab.py 的 keys、ngram_len、提示組或生成設定開始。但換了設定,舊門檻不會自動繼續有效;應重新生成校準與測試資料,保留未水印 negative,然後重跑 audit。這比先替畫面放一個漂亮的「AI 機率」數字重要。
城武觀點
我支持把浮水印當成可查證的來源線索,反對把它升格成作者身分裁判。這次同一套流程能檢出全部水印測試樣本,也能把未水印對照中的三份判成陽性;連轉成文字再讀回,七份水印樣本的 token 序列都變了。真正要交付的不是一個分數,而是分數的有效條件。正式密鑰不必為了透明而公開,但持有密鑰、掌握驗證權的一方,仍應交代適用長度、校準分布、誤報與申訴方式。這份小實驗沒有評判商用 Claude 的能力;它讓我更不願接受只有「檢出」兩字、沒有檢查路徑的來源判斷。
城武的未解檔案——那個判你陽性的分數,也該附上它怎麼判錯的紀錄。
Sources
[2] Anthropic:How Claude’s text watermark works(2026-08-14,頁面列 2026-09-01 更新;2026-10-22 核對)
[3] Dathathri 等:Scalable watermarking for identifying large language model outputs(Nature,2024-10-23)
[4] Google DeepMind:SynthID Text 參考實作
[5] Google DeepMind/Hugging Face:Introducing SynthID Text
[6] Transformers v4.57.1:SynthID logits processor
[7] Transformers v4.57.1:SynthID detector 與遮罩處理
[1] 原文:How Claude Watermarks AI-Generated Text(Sebastian Raschka,Ahead of AI,2026-08-22)