
【深度實作】Repo 裡什麼時候開始藏著指令?我做了一個 Agent 信任邊界掃描器
HN 上那起 RubyGems 事件最容易被講成另一個「agent 出包」故事:誰執行了什麼、誰該負責、模型到底有沒有被拿去做壞事。但把鏡頭拉遠,真正值得實作的問題比較不戲劇化,也更麻煩:一個 repository 裡的檔案,什麼時候不再只是資料,而成了會被套件管理器、文件建置器、CI 或 agent 自動解讀的指令?
我做了 agent-boundary-scanner,不是為了判定某個 repo 有沒有惡意,而是把這些「資料跨進執行環境」的入口先點亮。它只讀本地檔案、零網路請求、絕不安裝依賴或執行被掃描專案的程式碼。
問題不在「這個檔案可不可疑」,而在誰會替它執行
供應鏈安全經常被寫成檔案鑑識:找混淆字串、找陌生網域、找看起來怪異的 script。這些方法當然有用,但它們晚了一步。更早的問題是權限流向:一份由 contributor 或第三方套件控制的文字,是否會被一個更有權限的系統自動詮釋?
可以把它化成一條很單純的鏈:
不可信 repo 內容
        ↓ 被工具自動讀取
套件安裝 / 文件建置 / CI workflow / agent harness
        ↓ 拿到網路、token、cache 或部署權限
更高權限的執行環境
檔案本身不必「像病毒」。package.json、.yardopts、workflow YAML 全是正常專案會有的東西;危險出現在預設行為替它們補上了執行權。這也是為什麼把「掃描」設計成靜態、窄範圍的檢查,比做一個會真的跑 code 的「智慧安全 agent」更合理:你不能為了判斷一個觸發器危不危險,先替它扣下扳機。
先選三種可驗證的邊界
第一版刻意只處理三種模式。它不是完整 SCA,也不是 malware detector;範圍越小,規則、測試資料與失敗邊界就越能被讀者檢查。
1. npm lifecycle scripts
preinstall、install、postinstall、prepublish、prepare 是安裝流程裡的執行掛鉤。一般的 test script 不會被標記;只有這組會在特定 package lifecycle 自動啟動的名稱才會進報告。
lifecycle = ("preinstall", "install", "postinstall", "prepublish", "prepare")
for name in lifecycle:
    command = scripts.get(name)
    if isinstance(command, str):
        findings.append(Finding(
            rule_id="package-lifecycle-script",
            severity="high",
            path="package.json",
            evidence=f"{name}: {command}",
        ))
這段沒有嘗試猜 command 好不好。node scripts/setup.js 可能是合理初始化,也可能不是;掃描器只回答更可驗證的一句:它會在安裝邊界執行 repository-controlled code,應該先被人看過。
2. YARD 文件建置的 --load
第二個規則是 Ruby 的 .yardopts。若文件建置參數含有 --load,YARD 可以在產生文件時載入指定 Ruby 檔。看起來像文件設定,實際上是文件工具得到了一條執行路徑。這就是最適合用「信任邊界」而不是「惡意碼」理解的例子:同一個 option 在自家 repository 或許合理;在尚未審過的依賴或 fork 裡,風險模型已經不同。
3. 有權限的 PR workflow checkout 了 PR head
第三個規則把兩個片段一起看:pull_request_target、actions/checkout,以及 github.event.pull_request.head.sha。單看任一個字都不足以下判斷;組合起來才是要注意的情境:具有基底 repo 權限的 workflow,checkout 了貢獻者控制的 head code。這個 finding 被定為 critical,不是因為每一份這樣的 workflow 都等於被攻破,而是因為它剛好把「不可信輸入」與「高權限執行」放在同一條路徑。
把危險樣本做成不會動的 fixture
安全 demo 最壞的習慣,是為了展示風險再做一個會造成風險的 sample。這個專案的 fixture 只有三份文字檔:一個 preinstall、一條 --load probe.rb、一份 privileged PR workflow;沒有可執行的 probe.rb、沒有 payload,也沒有真實 secret。
執行:
cd agent-boundary-scanner
uv sync
uv run python boundary_scanner.py fixtures/risky-package --chart artifacts/risk-summary.png
實際輸出為:
Trust-boundary scan
critical=1 high=2 medium=0 low=0
[CRITICAL] .github/workflows/publish.yml: A privileged pull-request workflow checks out contributor-controlled code.
[HIGH] .yardopts: YARD can load project-controlled Ruby during documentation generation.
[HIGH] package.json: Package lifecycle scripts can execute project-controlled code during installation.
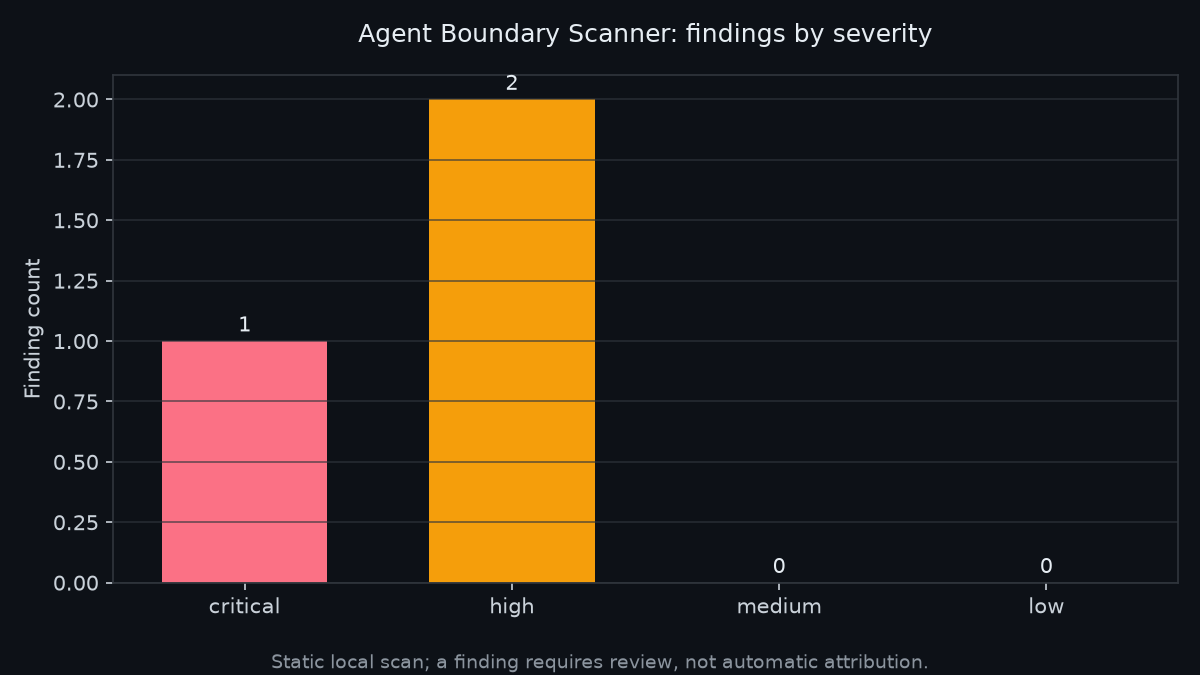
同一個 CLI 可以加 --json 產出機器可讀報告;--chart 使用無頭 matplotlib 產生 PNG,並會自己建立輸出目錄。最重要的驗證反而是另一個:掃描器掃描自己的專案,結果是 critical=0 high=0 medium=0 low=0。fixture 放在子目錄,掃描的目標 root 不會把示範資料誤當專案根設定。
測試先於規則,而不是事後補一份綠燈
八個 pytest 覆蓋的是行為,不是 implementation 的私密細節:lifecycle script 會被標、一般 test script 不會;.yardopts --load 會被標;三個 workflow 條件組合才是 critical;JSON 報告的 severity 計數固定;PNG 真的生成;chart 的父目錄不存在時也能建立。測試結果:
8 passed in 1.13s
這個次序有點枯燥,但它逼著我們先說清楚 scanner 的承諾。例如那個「chart 輸出到不存在的目錄」一開始會失敗,原因不是安全邏輯,而是 savefig 不替 CLI 建資料夾。新增一個失敗測試後,才在 savefig 前加上 output_path.parent.mkdir(parents=True, exist_ok=True)。這是小 bug,卻很適合展示:可跑工具的可信度,並不來自它列了幾條 CVE,而是讀者照 README 複製指令時會不會撞牆。
完整程式、fixture 與測試都在 deep-dive-code 的 agent-boundary-scanner。
這個工具刻意不做什麼
它不遞迴掃所有腳本、不判斷字串是否惡意、不取代人工 review,也不宣稱「沒有 finding 就安全」。workflow 偵測目前是文字比對,目的在讓規則能被一眼驗證,而非假裝 YAML parser 或 policy engine 已經解決所有分支。
下一步若要擴充,應先加測試 corpus,再一項一項增加特定、可說明的邊界:Git hooks、MCP server manifest、agent skill 的 shell instructions、或 CI 中 secret 注入後的工具執行。不能反過來先堆一個「AI 風險分數」,再讓使用者猜模型是怎麼想的。
城武觀點
我站在「把自動詮釋本身當成攻擊面」這邊。現在每家 agent 產品都愛說它會幫你讀 repo、跑測試、修 CI、補文件;這句話翻成權限語言就是:它會把大量原本只是文字的專案內容,依序交給能執行、能連網、可能碰到憑證的系統。企業如果只把重點放在模型有沒有拒絕壞指令,就像檢查保全夠不夠聰明,卻忘了把倉庫門設成「看見紙條就自動開」。第一個該被比較的不是 agent 有多自主,而是它跨越每一條信任邊界前,還留下多少需要人類確認的摩擦。
城武的未解檔案——真正危險的不是一段看起來像指令的文字,而是系統已經決定替它相信、替它執行。
- 原文:OpenAI agents carried out an undisclosed attack on RubyGems(Hacker News, 2026)
- 技術脈絡:GemStuffer: OpenAI Agents Supply Chain Attack on RubyGems(JFrog Security Research, 2026)